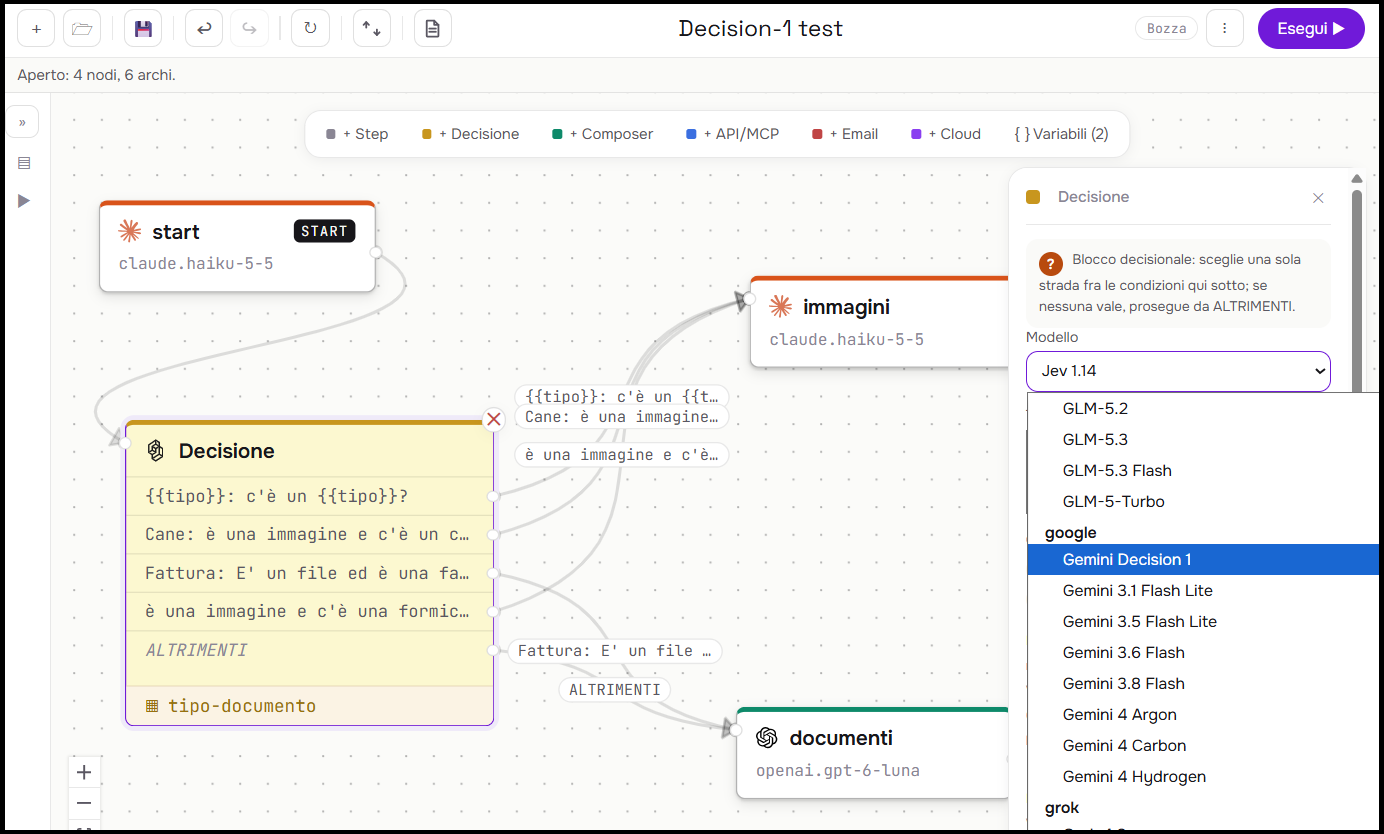
Quando costruisci un workflow AI in produzione, ti accorgi presto che metà del lavoro non richiede di scrivere una sola riga di prosa. Serve smistare un ticket nella coda giusta, capire se un testo contiene dati sanitari di una persona riconoscibile, valutare una fattura rispetto a una rubrica o decidere se attivare il ramo di ripiego.
Per fare questo mestiere, usare un LLM generativo significa pagare token di uscita che non ti servono, aspettare la decodifica sequenziale parola per parola, incrociare le dita sul parser JSON e fidarti di probabilità verbali quasi mai calibrate. Per questo in Canonity — dove ogni workflow è un grafo leggibile di blocchi e ogni blocco sceglie il proprio modello — abbiamo introdotto dietro lo stesso endpoint una classe diversa di motori: i valutatori probabilistici puri, quelli che TypeSafe chiama modelli System One e Google serve con la Decisions API .
Non fanno chat e non generano testo, ricevono uno stato e una lista di domande chiuse, e restituiscono probabilità in un singolo passaggio.
Visto che l’11 novembre Google ha deciso di mettere a disposizione decision-1 l’abbiamo messo alla prova insieme all’altro valutatore oggi attivo nel catalogo di Canonity (Jev) per capire che cosa cambia davvero quando passi dalla scheda tecnica del fornitore al traffico reale. Qui racconto che cosa ti permette di scegliere l’architettura di Canonity e che cosa dicono i numeri che abbiamo misurato.
Un contratto unico davanti ai motori: come lavorano gli elementi di Canonity:
In Canonity la regola architetturale è semplice: l’applicazione chiamante e la logica del workflow non devono dipendere dalla sintassi privata di un singolo fornitore. Dietro il layer Canonity-LEO convivono oggi tre record espliciti:
jev.1-13(TypeSafe Jev 1.13, attivo in C.LEO dal 27 settembre);jev.1-14(TypeSafe Jev 1.14, rilasciato da TypeSafe il 14 ottobre);google.decision-1(Google Gemini Decision 1, lanciato l’11 novembre e attivo in Canonity dal 13 novembre).
Esporre tutto dietro una sola rotta non serve solo a cambiare modello con un clic quando esce una versione nuova, ma permette di governare quattro scelte operative che, lasciate al codice applicativo sparso, prima o poi rompono i flussi in produzione.
1. Versioni fissate, mai alias mobili. C.LEO espone jev.1-13 e jev.1-14 come versioni esatte. Su questo punto la documentazione TypeSafe è chiara: alias come jev-latest si spostano automaticamente al rilascio successivo (come avvenuto una settimana dopo il lancio della 1.14), cambiando le distribuzioni di confidenza senza che tu abbia toccato una riga di codice. Chi ha tarato una soglia di routing su una versione non può scoprire di lunedì mattina che il proprio router ha iniziato a deviare traffico altrove…
2. Capability gating sugli allegati. Il nostro orchestratore Canonity-BK-e non invia mai file a un valutatore se il record di catalogo di C.LEO non ne dichiara il supporto stabile. TypeSafe ha abilitato le immagini sia su Jev 1.13 sia su Jev 1.14, ma le definisce ancora «Dreamer-ready» (non pronte per la produzione) dietro l’intestazione TypeSafe-Danger-Zone-Images: true. Inoltre impone vincoli pesanti: accetta solo PNG o JPEG baseline tra 280 e 1.568 pixel per lato, rimuove i metadati EXIF senza ruotare i pixel (una foto verticale da telefono può arrivare sdraiata), non legge i PDF, riconta l’immagine ogni volta che ne citi il riferimento e non documenta ancora quanti token consumi. Il 14 novembre abbiamo verificato in esercizio tre corse di router su Jev: sono partite tutte senza allegato, esattamente come previsto. Se un blocco richiede immagini o PDF, oggi può passare solo da Decision 1.
3. Primitive normalizzate e fan-out speculativo. Tutti e tre i motori gestiscono domande binarie sì/no (Noul), scelta singola fino a 255 opzioni (Choice) e valutazione su rubrica (Score). Anche se Decision 1 accetta tecnicamente fino a 255 livelli per Score e 1.000 domande per chiamata, C.LEO impone un massimo di 10 livelli (in linea con la raccomandazione della stessa Google di restare tra 2 e 10 livelli) e 64 domande per richiesta. Sessantaquattro domande in una chiamata bastano per applicare il pattern più utile di questi modelli, il fan-out speculativo: inviare nello stesso pacchetto tutte le verifiche possibili su uno stato condiviso, pagando i token del testo in ingresso una volta sola. Sul fronte box (localizzazione con coordinate in un’immagine introdotta in Jev 1.14), abbiamo scelto di non esporlo finché resta sperimentale, anche perché la primitiva restituisce sempre un riquadro senza stato «non trovato» e costringerebbe ogni flusso ad affiancarle una verifica Noul.
4. Controlli di stabilità sui media. Per contenere i picchi di latenza e banda sulle valutazioni con allegati — oggi instradate solo su Decision 1 — C.LEO fissa un tetto di 8 file, 25 MiB complessivi per richiesta e 2 valutazioni multimediali simultanee, rispondendo «riprova» alla terza richiesta concorrente.
La prova del 14 novembre sul testo italiano
Il 14 novembre 2026 abbiamo fatto girare su C.LEO in esercizio 13 casi finti in italiano — frasi semplici, negazione, ironia, periodo ipotetico, distinzione tra dati sanitari personali e semplice testo medico, tre scenari di router (incluso un caso ambiguo costruito apposta e una richiesta fuori tema), classificazione documentale e punteggio — ripetendo ogni caso tre volte per ciascun modello.
Una precisazione di metodo prima dei numeri: nelle tabelle riportiamo 33 risposte giuste su 33 per tutti e tre i motori, perché sugli 11 casi con risposta discreta attesa per 3 ripetizioni nessuno dei tre ha commesso errori (restano fuori dal conteggio binario il caso di punteggio continuo e il caso di router intenzionalmente ambiguo privo di classe univoca).
| Metrica misurata (14 nov 2026) | Jev 1.13 (jev.1-13) | Jev 1.14 (jev.1-14) | Gemini Decision 1 (google.decision-1) |
|---|---|---|---|
| Risposte esatte sui casi discreti | 33 su 33 | 33 su 33 | 33 su 33 |
| Esiti diversi rispetto a Jev 1.13 | — | 0 su 13 | — |
| Tempo mediano per valutazione | 189 ms | 186 ms | 218 ms |
| Token in ingresso mediani | 316 | 316 | 126 |
| Oscillazione massima tra 3 ripetizioni | 0,08 | 0,06 | 0,00 |
Sul testo breve in italiano i tre valutatori sono sostanzialmente equivalenti per tempi ed esito. Le latenze mediane (186–218 ms) cadono in pieno dentro gli intervalli dichiarati dai fornitori: 70–500 ms per TypeSafe e 150–250 ms end-to-end per Google. Tra Jev 1.13 e Jev 1.14 non è cambiato un solo esito su 13 casi: il «multilingue migliorato» annunciato da TypeSafe per la 1.14 su questo set non emerge, perché già la 1.13 non sbagliava.
Anche nei passaggi insidiosi hanno retto tutti: su una negazione forte («non lo restituirei per niente al mondo»: vuole restituire?) Jev sta a 0,03–0,04 e Decision 1 a 0,01; sull’ironia («un servizio impeccabile, come sempre»: è soddisfatto?) Jev segna 0,06–0,08 e Decision 1 0,02; sul riconoscimento di dati sanitari riferiti a una persona identificabile viaggiano tutti tra 0,97 e 0,99, crollando a 0,01–0,03 sullo stesso argomento medico senza persona. L’unica sfumatura linguistica da annotare compare sul condizionale («se entro venerdì… annullo»: ha già annullato?), dove Decision 1 sale a 0,15 contro 0,04–0,05 di Jev: un valore comunque lontano da qualsiasi soglia di attivazione, ma che segnala una sensibilità leggermente diversa alle formule ipotetiche.
Il conto vero lo fa l’orchestratore: determinismo e costi
Se ci fossimo fermati al listino pubblico, avremmo tratto una conclusione sbagliata. TypeSafe fattura Jev a 0,042 dollari per milione di token in ingresso (uscita gratis), mentre Google chiede 0,10 dollari per milione di token su Decision 1 (zero token in uscita): a parità di token, Decision 1 costa 2,381 volte Jev. Il pareggio si ottiene solo se Decision 1 consuma al massimo il 42,00% dei token usati da Jev sulla stessa domanda.
Sui nostri prompt testuali brevi in italiano la mediana è stata di 126 token su Decision 1 contro 316 su Jev — esattamente il 39,87%. Una singola chiamata elementare costa quindi 0,00001260 dollari con Google contro 0,00001327 con TypeSafe: in pratica costano uguale.
Poi però entra in scena il comportamento reale del nostro orchestratore C.BK-e, che per sicurezza legge ogni domanda di routing due volte e fa partire una terza lettura se le prime due differiscono alla seconda cifra decimale, e fa emergere la differenza architetturale più netta tra i due motori:
- Jev oscilla: il suo campionamento parallelo ha prodotto scarti fino a
0,08sulla 1.13 e0,06sulla 1.14. Basta un0,99seguito da1,00per far scattare la terza chiamata: nella prova è successo 1 volta su 4 con la 1.13 (moltiplicatore medio2,25x) e 2 volte su 4 con la 1.14 (moltiplicatore2,50x). - Decision 1 è deterministico: nella nostra prova il suo passaggio prefill singolo ha restituito varianza
0,00su tutte le ripetizioni . Con C.BK-e la terza lettura non parte mai, ma la seconda lettura raddoppia comunque costi e consumo di concorrenza per ottenere la copia esatta della prima risposta.
Tradotto in spesa su 1 milione di decisioni testuali brevi, l’effetto combinato cambia completamente la classifica:
| Configurazione di valutazione (testo breve C.LEO) | Moltiplicatore C.BK-e | Costo per 1 decisione | Costo per 1 milione di decisioni |
|---|---|---|---|
| Jev 1.13 (chiamata singola senza C.BK-e) | 1,00x | 0,00001327 $ | 13,27 $ |
| Jev 1.13 con C.BK-e (25% terza lettura) | 2,25x | 0,00002986 $ | 29,86 $ |
| Jev 1.14 con C.BK-e (50% terza lettura) | 2,50x | 0,00003318 $ | 33,18 $ |
| Decision 1 con C.BK-e attuale (doppia lettura) | 2,00x | 0,00002520 $ | 25,20 $ |
| Decision 1 ottimizzato (lettura singola) | 1,00x | 0,00001260 $ | 12,60 $ |
Con la configurazione attuale di C.BK-e, sui testi brevi Decision 1 è già più economico del 15,6% rispetto a Jev 1.13 e del 24,1% rispetto a Jev 1.14; togliendo la seconda lettura ridondante su Decision 1 si scende a 12,60 dollari per milione di decisioni, risparmiando il 57,8% rispetto a Jev 1.13 e il 62,0% rispetto a Jev 1.14, e raddoppiando subito la capacità effettiva sul tetto delle 2 chiamate multimediali simultanee.
C’è però un’avvertenza fondamentale per chi legge questi numeri: evita di estrapolarli ai documenti lunghi. I 190 token di distanza misurati su C.LEO (316 contro 126) pesano moltissimo su una frase di pochi byte, ma quando lo state passa a migliaia di token (un lungo contratto, una trascrizione, un referto) quel divario iniziale si diluisce e torna a comandare il listino per token di Jev (0,042 contro 0,10 dollari). Non è un caso che nelle suite condivise pubblicate da Google (7 benchmark completi) Jev 1.14 spenda 0,68 dollari contro gli 0,88 di Decision 1 (e i 4,14 di Gemini 3.5 Flash-Lite), e che nelle valutazioni di Artificial Analysis riportate da Lindy il costo per suite di Jev sia meno della metà (156 dollari contro 345). Inoltre, né Decision 1 né Jev (secondo quanto documentato finora) offrono oggi context caching o Batch API come fa invece GPT-6 Luna: l’unico modo strutturale per abbattere la bolletta sui documenti corposi resta impacchettare più domande nello stesso stato.
La soglia a 0,65 e due caratteri opposti sull’incertezza
Il risultato più istruttivo dell’intera giornata riguarda un singolo caso di router che avevamo scritto apposta per essere ambiguo (risposta attesa: nessuna rotta sicura).
- Jev 1.13 ha scelto «rimborso parziale» con confidenze
0,75,0,83e0,79(media0,790, deviazione standard0,0400). - Jev 1.14 ha scelto «rimborso parziale» con
0,79,0,73e0,75(media0,757, deviazione standard0,0306). - Decision 1 ha restituito la stessa opzione a
0,45,0,45,0,45.
Il nostro router C.BK-e usa una soglia fissa di 0,65, tarata nei mesi scorsi su Jev. Sotto 0,65 il flusso entra nel ramo «altrimenti». Morale: davanti allo stesso messaggio ambiguo, Jev prende una decisione netta e instrada il caso; Decision 1 si ferma sotto la metà e consegna il controllo al ramo di ripiego.
I benchmark esterni spiegano molto bene perché succede: sull’indice indipendente Artificial Analysis Decision Index (riportato da Lindy), Jev 1.14 e Gemini Decision 1 pareggiano esattamente a quota 66 (davanti a GPT-6 Luna a 60), con Jev 1.14 leggermente avanti nei compiti di selezione tool e navigazione web come When2Call (82,0% contro 79,9%) e Mind2Web. Ma quando Google confronta la calibrazione delle probabilità, Decision 1 registra un errore di calibrazione di 0,0250 contro 0,0494 di Jev 1.14 (e 0,2104 per un generativo compatto come Gemini 3.5 Flash-Lite).
In più, Decision 1 restituisce un campo esplicito confidence anche sulle domande binarie noul, mentre TypeSafe su Noul espone solo la probabilità p assumendo che nella domanda sì/no probabilità e certezza coincidano. Da questa differenza nasce una regola operativa per chi usa Canonity: non si cambia valutatore in un blocco lasciando invariata la soglia a 0,65. Se sposti un workflow su Decision 1 mantenendo la soglia calibrata su Jev, il flusso diventerà di colpo molto più cauto e manderà molti più casi nel ramo «non lo so» — una scelta ottima se vuoi ridurre i falsi positivi automatici, ma una regressione silenziosa se non la metti in conto.
Immagini e PDF su Decision 1: costi piatti e una leva ancora spenta
Sui documenti visivi, le corse di prova del 13 e 14 novembre su Decision 1 hanno restituito un comportamento molto lineare lato token e uno da gestire lato latenza:
- un PNG minuscolo (
8x8pixel, 75 byte) ha consumato 1.089 token; - una foto PNG da 1,6 MB ha consumato 1.080 token;
- un’immagine PNG da 7,3 MB ha consumato 1.064 token;
- un PDF di una pagina ha consumato 520 token per il media (circa
740complessivi col prompt).
A configurazione standard, un’immagine pesa intorno a 1.080 token indipendentemente dai byte del file — circa 0,000108 dollari a chiamata (poco più di 10 centesimi ogni mille valutazioni), mentre un PDF di una pagina costa circa 0,000074 dollari (7 centesimi ogni mille). La dimensione in byte sposta però il tempo di risposta: 0,7–1,4 secondi su file da 1–2 MB, fino a 3,3 secondi sul PNG da 7,3 MB.
Sulle immagini e sui PDF restano due margini tecnici su cui stiamo già guardando dentro Canonity. Il primo è il parametro media_resolution offerto dalla Decisions API (low, medium, high e ultra_high per le immagini), che permette di tagliare il consumo di token dove basta una classifica visiva grossolana o alzare la nitidezza su scontrini e documenti con testo minuto. Il secondo riguarda l’infrastruttura dei file: la documentazione Google ricorda che l’endpoint rifiuta gli URL di YouTube e gli URI diretti gs:// di Cloud Storage, richiedendo byte inline, URL HTTPS fino a 15 MB oppure la Files API — un dettaglio che il nostro adapter assorbe, ma che va tenuto presente nel disegno dei limiti di C.LEO.
Privacy, dati sanitari e sicurezza dell’input: il confine europeo
Chi progetta workflow privacy-by-design — e a maggior ragione chi tocca il dominio sanitario — deve guardare oltre i millisecondi. Su questo terreno l’analisi dei termini di servizio ci consegna una verità scomoda ma netta: nessuno dei due servizi pubblici garantisce oggi residenza dei dati nell’Unione Europea.
TypeSafe ospita il servizio pubblico negli Stati Uniti: dichiara di non addestrare sui dati dei clienti, pubblica un DPA con Clausole Contrattuali Standard (SCC) e possiede certificazione SOC 2 Type II, ma riserva la zero data retention (ZDR) ai soli clienti Enterprise mentre sui piani standard trattiene temporaneamente i payload per monitoraggio abusi senza indicare la finestra temporale. Google, dal canto suo, non addestra sui dati inviati al servizio a pagamento della Gemini API (e per questo in produzione va tenuto rigorosamente separato dal piano gratuito di prototyping di Google AI Studio), ma dichiara che il trattamento può avvenire in qualunque paese in cui gestisce strutture, conserva i dati per un periodo limitato contro gli abusi e applica termini distinti dai servizi Google Cloud Platform.
In Canonity proteggiamo già il perimetro della piattaforma cifrando i file caricati con AES-256-GCM, non conservando i prompt oltre l’esecuzione e non inoltrando ai provider terzi IP, email o dati del dispositivo dell’utente. Tuttavia, se il payload del blocco contiene dati personali o sanitari che non devono uscire dall’Europa, cifrare il canale non basta. La regola di progettazione è doppia:
- Minimizzare e pseudonimizzare a monte: a un blocco di routing quasi mai serve il nome, il codice fiscale o il telefono del paziente per capire di quale pratica si tratta.
- Tenere disaccoppiato il contratto di C.LEO: qualora un cliente abbia vincoli stringenti di sovranità UE sui dati di routing, avere tutti i workflow dietro un endpoint astratto permette di inserire domani valutatori già progettati per EU Data Zone — come Microsoft-Decision-1 su Microsoft Foundry (solo testo fino a 32K token a
0,042dollari per milione) — o motori open-weight auto-ospitabili come Cloudflare Clef.
C’è poi un secondo aspetto di sicurezza che raramente viene citato nelle demo: la manipolabilità del testo in ingresso (prompt injection). TypeSafe documenta con grande onestà che Jev tende a letture letterali, è debole su aritmetica, conteggi e ordinamento cronologico delle date, perde precisione quando lo state è gonfiato da campi JSON irrilevanti e non considera ostile il contenuto dello state per impostazione predefinita, consentendo a testo scritto da un attaccante (ad esempio in un oggetto email o nel commento di un comando) di spostarne la decisione . Google dichiara invece di usare Gemini Decision 1 proprio come livello di sicurezza anti-avversariale davanti agli strumenti MCP di Search, ma manca ancora una verifica indipendente sulla resistenza ad attacchi scritti in italiano.
Che cosa queste misure non dicono (e i prossimi passi)
Tredici casi costruiti da noi servono a verificare che le integrazioni funzionino e a cogliere differenze macroscopiche di comportamento, non a certificare l’accuratezza statistica di un sistema in produzione. Applicando un intervallo esatto di Clopper-Pearson al 95% di confidenza, un risultato perfetto di 13 su 13 casi indipendenti garantisce appena un limite inferiore di accuratezza reale del 75,3% a due code: anche un modello che in realtà sbaglia il 10% delle volte ha più di una probabilità su quattro (25,4%) di superare 13 prove senza errori. Per misurare un’accuratezza intorno al 90% con un margine di errore di circa 3,4 punti percentuali servono almeno 300 casi reali etichettati presi dal traffico vero.
Per questo, chiusa questa prima fotografia, la nostra tabella di marcia su C.LEO e C.BK-e prevede quattro interventi pratici:
- Togliere la seconda lettura obbligatoria in C.BK-e per
google.decision-1, mantenendo solo controlli statistici a campione, per tagliare subito il costo sul testo breve e sbloccare l’intera concorrenza sugli allegati. - Costruire un set di validazione da almeno 300 casi italiani reali con negazioni annidate, ironia non scolastica, gergo settoriale e casi ambigui, così da tarare soglie di routing distinte per Jev e per Decision 1 al posto dell’attuale
0,65unico. - Misurare il punto di incrocio sui testi lunghi (da poche migliaia fino alle decine di migliaia di token) per sapere con esattezza da quale lunghezza convenga passare a Jev.
- Testare PDF multi-pagina con testo piccolo e profili
media_resolutionsu Decision 1.
Nel frattempo, ecco la bussola pratica con cui oggi scegliamo il valutatore nei nostri workflow:
| Scenario del blocco in Canonity | Scelta consigliata oggi | Perché |
|---|---|---|
| Decisione su testo breve dove nei casi dubbi preferisci «altrimenti» | google.decision-1 (con 1 lettura e soglia ritarata) | Calibrazione migliore, varianza nulla e costo inferiore con C.BK-e |
| Decisione su documenti testuali lunghi (entro 32K token) | jev.1-13jev.1-14 | Listino di 0,042 $/1M imbattibile quando il peso del testo diluisce l’overhead iniziale. |
| Immagini, PDF o testi lunghi fino a 262K token senza Danger Zone | google.decision-1 | Unico supporto multimodale pronto per la produzione e PDF da 1 pagina a ~520 token. |
| Scelta di tool in workflow agentici complessi in inglese | jev.1-14 (da validare sul proprio traffico) | Primo davanti a Decision 1 nei benchmark When2Call e Mind2Web. |
| Dati personali o sanitari che non possono lasciare l’UE | Nessuno dei due su API pubblica senza pseudonimizzazione | Entrambi trattano fuori da garanzie di residenza UE sulle rotte pubbliche standard. |
Lascia un commento