Categoria: Blog

  • Ho resuscitato il sogno di Feigenbaum e dei sistemi esperti

    Ho resuscitato il sogno di Feigenbaum e dei sistemi esperti

    C’è un filo che lega l’ubriacatura per l’intelligenza artificiale di oggi a un’epoca che molti conoscono solo per sentito dire: la metà degli anni Ottanta.

    Io quegli anni me li ricordo bene. C’ero.

    Ricordo l’aria del 1985, l’elettricità attorno alla sfida giapponese della Quinta Generazione, i manuali, la sensazione netta che stessimo per catturare l’intelligenza umana dentro una scatola logica. Edward Feigenbaum, da Stanford, aveva formulato un principio tanto limpido quanto radicale:

    “Il potere di un sistema intelligente non sta negli algoritmi generali di ragionamento, ma nella quantità e nella qualità delle conoscenze specialistiche che possiede.“

    Era l’era dei sistemi esperti. L’obiettivo era clonare la testa dei migliori specialisti — ingegneri, medici, periti — e tradurla in una base di conoscenza fatta di regole (SE… -> ALLORA) e in un motore inferenziale che le applicava. XCON, alla Digital, configurava i VAX meglio di molti tecnici: arrivò a oltre diecimila regole, e a una squadra intera per tenerle in piedi. Sembrava l’inizio di una rivoluzione definitiva.

    Invece arrivò il muro. Lo stesso Feigenbaum lo battezzò knowledge acquisition bottleneck: il collo di bottiglia dell’acquisizione della conoscenza: per costruire un sistema esperto servivano mesi di interviste.

    L’ingegnere della conoscenza torchiava l’esperto, gli estraeva (a fatica) le euristiche, le codificava a mano in migliaia di righe rigide. Un lavoro titanico, costosissimo e fragile: bastava un’eccezione non prevista perché il castello crollasse. E soprattutto: la macchina sapeva tutto di un mestiere e non imparava niente. Per insegnarle una cosa nuova serviva qualcuno che la scrivesse.

    Il mercato si disilluse, i budget furono azzerati, arrivò il lungo inverno dell’IA. Abbiamo archiviato tutto, convinti che quella strada fosse impraticabile.

    Salto in avanti. Anno 2026.

    Io ci sono anche qui.

    Dopo gli anni della fascinazione indiscriminata per i modelli linguistici — capaci di conversare su tutto, ma strutturalmente inaffidabili nei contesti verticali dove non è concesso sbagliare — in Canonity ci siamo fatti una domanda che per me aveva il sapore di un conto rimasto aperto per quarant’anni:

    Se un modello linguistico oggi fa l’acquisizione da solo, leggendo e strutturando moli immense di documenti, perché non riprendere il meccanismo dei sistemi esperti del 1985, ora che il collo di bottiglia è superabile?

    L’abbaglio degli ultimi tempi infatti è stato credere che bastasse dare in pasto un PDF a una chat, o costruire una pipeline RAG, per ottenere un professionista sintetico. E, spoiler, no, non funziona così. Il RAG ripesca frammenti simili alla domanda. Il linguaggio naturale senza architettura produce solo parodie probabilistiche dell’esperienza umana.

    La risposta che abbiamo costruito in Canonity parte da una formula precisa:

    La “competenza” di Canonity è il sistema esperto di Feigenbaum con l’acquisizione fatta dal modello e la curatela fatta con l’autore. È quello che avremmo voluto nel 1985, con un pezzo in più: la skill.


    Il collo di bottiglia rovesciato

    Nel nostro schema l’esperto non subisce più l’interrogatorio di un programmatore, ma semplicemente carica i documenti che ha: manuali, listini, procedure come fonti permanenti; preventivi fatti, ticket risolti come esempi. E, scometti? È il modello a fare il lavoro sporco: distilla gli esempi togliendo nomi, importi e dati riservati e tenendo ciò che insegnano; dà un verdetto a ogni documento rispetto allo scopo dichiarato; mette i documenti in relazione fra loro e trova dove si contraddicono; formalizza una prima architettura della conoscenza.

    Ma l’automazione lasciata a se stessa può inventare. Ed è qui che scatta la svolta: è l’esperto quello che valida.

    Risponde alle domande che il sistema gli propone dopo avere studiato i documenti e trovato cose che ha capito male. L’esperto decide, quando due fonti si contraddicono, quale vale. Corregge un’interpretazione con una nota, e la nota diventa parte della competenza come se fosse un documento. Approva lo schema del dominio. E prova: salva richieste vere e le fa rigirare a ogni revisione, per vedere se la competenza risponde come vuole lui, e se l’ultimo documento caricato ha peggiorato qualcosa.

    Finché non ha guardato, la competenza aggiornata non entra in esercizio.

    Non si estrae più la conoscenza col cucchiaino. Il modello costruisce l’impalcatura, l’esperto la verifica e la firma.


    Il pezzo in più: che cos’è davvero una skill.

    Nel 1985 avevamo basi di conoscenza statiche e motori inferenziali rigidi. Nel 2024 ci siamo accontentati di prompt fragili, affidati alla buona sorte della probabilità. Nel 2026 tutti vendono skill.

    Ed è giusto: una skill è una cosa seria che funziona, è la procedura: che cosa fare, in che ordine, con quali strumenti, che cosa controllare prima di consegnare, quando fermarsi. Una skill sa come si fa un lavoro.

    Quello che una skill non sa è che cosa si sa in quell’azienda: il catalogo, le regole di sconto, le eccezioni che si fanno da dieci anni e che nessuno ha mai scritto. Una skill senza competenza è un bravo professionista al primo giorno in un’azienda che non conosce. Una competenza senza skill è una biblioteca.

    Le due cose si affiancano. La skill dice come si fa; la competenza dice che cosa si sa. E la competenza è un oggetto fisico, non appartiene a nessun modello: si aggancia a quello che l’autore sceglie, e se domani lo cambia, resta.


    Un esempio: il catalogo e i cinque preventivi

    Un’azienda vende impianti su misura. Carica il catalogo tecnico e le regole di sconto come fonti permanenti, e cinque preventivi già inviati come esempi.

    L’elaborazione distilla i preventivi: via i nomi dei clienti e gli importi puntuali, restano i criteri di scelta. Poi il sistema trova una discrepanza e bussa alla porta dell’esperto:

    C’è una contraddizione: un preventivo applica il 15% di sconto, la regola dice al massimo il 10%. Era un errore o un’eccezione?

    L’autore risponde:

    Un’eccezione: vale solo per i clienti conosciuti in fiera.

    In quell’istante la risposta entra nella competenza e ci resta.

    Ora agganciamo la competenza alla skill «rispondi a una richiesta di preventivo, usando il listino di settembre 2026 (path/al/listino.xlsx)». Da quel momento ogni richiesta che entra — in chat, o da un workflow che legge la posta — esce con un preventivo coerente col catalogo, con le regole e con l’eccezione della fiera.

    E con il modello linguistico che l’autore preferisce oggi! Se domani ne esce uno migliore o più economico e lo sostituisce, la competenza non si rifà: non è del modello.


    Chiudere il cerchio

    Quarant’anni fa eravamo partiti con l’intuizione giusta e gli strumenti sbagliati. Poi abbiamo passato un decennio a credere che la forza bruta dei parametri potesse sostituire la specificità della conoscenza umana.

    Feigenbaum aveva ragione fin dal principio: l’intelligenza applicata è competenza di dominio, non generalismo. Oggi abbiamo il motore per estrarla, l’esperto per verificarla e la skill per metterla al lavoro.

    Il sistema esperto non è più una promessa incompiuta del 1985. È tornato. E stavolta impara.
  • La mezz’ora di Godwin

    La mezz’ora di Godwin

    Nel 1793 un filosofo calcolò che mezz’ora di lavoro al giorno sarebbe bastata a tutti. Oggi? Questa cosa ci terrorizza.

    Prova a dire a qualcuno che: da domani una macchina farà per te la parte noiosa del tuo lavoro. I riepiloghi, i documenti da compilare, le mail da smistare, le riunioni di allineamento (non solo il verbale…), il codice di routine.

    Lo vedrai irrigidirsi e prima ancora di chiedersi cosa fare delle ore liberate, si chiederà quanto durerà lo stipendio.

    La gente ha voglia di lavorare. In quarant’anni di mestiere ho conosciuto pochissime persone che volessero davvero non fare niente, e ne ho conosciute moltissime che non sopportavano quello che erano costrette a fare: il ripetitivo, il rendicontato, il «facciamo così perché si è sempre fatto così». Quando il lavoro ha un senso le persone lo cercano, lo difendono, ci restano fino a tardi senza che nessuno glielo chieda.

    Il paradosso è che la liberazione dalla fatica inutile, che per secoli è stata un’utopia, oggi che è raggiungibile la consideriamo una forma di minaccia. La realtà è che nel sistema in cui viviamo il lavoro eterodiretto è l’unico titolo che autorizza a mangiare e a contare qualcosa per gli altri.

    Tolta la fatica, con l’architettura attuale non avremo nemmeno il permesso di esistere.

    Mezz’ora al giorno

    Nel 1793 (più o meno 240 anni fa) William Godwin nella sua “Inchiesta sulla giustizia politica” si pose una domanda, che oggi suona attualissima: quanto lavoro serve davvero per mantenere una comunità? Non si fermò alla domanda ma fece proprio i conti e arrivò a una cifra imbarazzante. Se il lavoro manuale fosse stato distribuito equamente fra tutti gli adulti abili, eliminando le occupazioni che servivano solo al lusso di pochi e al mantenimento di apparati inutili, sarebbe bastata mezz’ora al giorno a testa.

    Per Godwin l’uomo liberato dalla fatica si sarebbe messo a studiare, a sperimentare, a rendersi utile: la curiosità e il desiderio di contribuire gli sembravano motori più forti del salario. Il tempo era, ai suoi occhi, la risorsa che la disuguaglianza sottraeva alla maggioranza per regalarla a una minoranza che viveva del lavoro altrui.

    Thomas Malthus cinque anni dopo gli rispose con un intero saggio sulla popolazione, per spiegargli che qualunque abbondanza sarebbe stata mangiata dalle nascite.

    E il dibattito è andato avanti così per due secoli.

    La stima ha fatto scuola e nel 1880 Paul Lafargue, ne Il diritto alla pigrizia, chiedeva tre ore al giorno; Bertrand Russell nel 1932, nell’Elogio dell’ozio, quattro. John Maynard Keynes nel 1930 scrisse che i suoi nipoti, intorno al 2030, avrebbero lavorato quindici ore a settimana e si sarebbero trovati davanti al vero problema: cosa fare del tempo.

    Mancano quattro anni alla scadenza di Keynes e la produttività per ora lavorata ha superato le sue stime, sebbene le ore siano rimaste più o meno le stesse.

    Dove è finito il tempo

    I guadagni di produttività ci sono stati, ed enormi. Sono andati però quasi tutti a chi possiede il capitale, sotto forma di dividendi, e molto poco a chi lavora, sotto forma di ore in meno a parità di paga.

    Poi è successa una cosa che Godwin aveva intravisto e che David Graeber ha raccontato nel 2018 con un titolo poco elegante, Bullshit Jobs: l’automazione della produzione materiale ha moltiplicato le mansioni di controllo, rendicontazione e coordinamento, lavori che chi li svolge spesso giudica inutili e che esistono soprattutto per tenere in piedi la disciplina del salario. Le occupazioni parassitarie che il filosofo voleva abolire, insomma, invece di sparire si sono vestite da ufficio.

    Chi ha letto Il riflesso e il midollo ha già incontrato Jevons: le macchine a vapore più efficienti fecero crescere il consumo di carbone invece di ridurlo. Con il lavoro di testa succede lo stesso. Ad esempio rendere la stesura di un documento o di un pezzo di codice dieci volte più veloce ha fatto esplodere la domanda di revisioni, allineamenti, versioni e conformità… e le ore? Sono rimaste le stesse.

    Lafargue aveva aggiunto l’ultimo pezzo già nell’Ottocento: nelle poche ore che gli restano, un lavoratore stanco consuma e tace.

    Il ricatto

    L’intelligenza artificiale si distingue dalle rivoluzioni precedenti per un motivo preciso: lavora sul linguaggio, sull’analisi, sul codice.

    La macchina a vapore ha sostituito i muscoli, il gestionale ha velocizzato la contabilità, questa entra nelle mansioni cognitive intermedie, riassumere, redigere, filtrare, prototipare. Esattamente la parte del lavoro che la gran parte delle persone, se potesse, lascerebbe volentieri a qualcun altro.

    Dovrebbe essere la buona notizia del secolo… E invece? Viene vissuta come una condanna perché il sistema converte ogni ora risparmiata collettivamente in un rischio individuale: meno ore necessarie, meno posti, meno titoli per sedersi a tavola.

    Ci hanno messo nella posizione di avere paura che, nel momento in cui la fatica se ne va, lo stipendio la segua.

    I numeri dicono che la gente vuole lavorare e allo stesso tempo smettere di sprecarsi. Fra giugno e dicembre 2022, in Gran Bretagna, 61 aziende e circa 2.900 dipendenti hanno provato per sei mesi la settimana di quattro giorni con il modello 100:80:100: stesso stipendio, 80% delle ore, stessa produzione attesa.

    Sembra assurdo ma alla fine il risultato è:

    • Il burnout dichiarato è sceso del 71%
    • Lo stress ridotto del 39%
    • I giorni di malattia? Due terzi meno!
    • Il fatturato medio? Cresciuto dell’1,4%…

    Alla fine 56 aziende su 61 hanno deciso di non tornare indietro e il 15% dei lavoratori ha dichiarato che nessuna cifra lo avrebbe convinto a tornare ai cinque giorni. Il lavoro è rimasto ma è aumentato il tempo per farne qualcos’altro.

    Le condizioni perché l’AI produca lo stesso effetto su scala si conoscono da tempo: orario ridotto a parità di paga, un reddito che non dipenda per intero dal posto (il reddito di base, finanziato tassando le rendite dell’automazione, è la versione più discussa) e una AI usata per togliere lavoro inutile invece che per contare i minuti di chi resta.

    Sono tre scelte politiche, e il bello è che la parte tecnica, per una volta, è già pronta.

    Le altre ventitré ore e mezza

    Godwin fece il suo conto in un’Inghilterra di campi e telai e lo presero per un sognatore. Due secoli dopo abbiamo costruito la macchina che rende quel conto credibile anche per il lavoro di testa, e la prima reazione collettiva è stata chiedere di spegnerla.

    Mi chiedo, e questa volta con paura, se sia perché la mezz’ora porta con sé una domanda scomoda, e cioè chi decide (o il non sapere) cosa fare delle altre ventitré ore e mezza.

    Chiedo: se da domani una macchina si prendesse la parte noiosa del tuo lavoro e lo stipendio restasse lo stesso, cosa faresti del tempo?

    … Ma soprattutto, quanto ci hai messo a pensare alla paga prima di pensare al tempo?

  • Il riflesso e il midollo

    Il riflesso e il midollo

    Jev, Laya e i modelli che decidono senza scrivere: cosa insegnano, anche giocando a Doom, a chi mette l’AI dentro il software.

    Il 15 settembre una startup di San Francisco ha presentato il suo primo modello e, fra le demo del lancio, lo ha messo a giocare a Doom, ovviamente il modello non vede lo schermo e non scrive una parola: riceve lo stato della partita descritto a testo, sceglie cosa fare e il marine si muove.

    Nella stessa pagina, con un’onestà che di questi tempi fa quasi tenerezza, gli autori ammettono che un bot tradizionale, senza un grammo di intelligenza artificiale, potrebbe giocare meglio.

    A Doom, del resto, nessuno chiedeva di vincere, serviva a dimostrare quello che chi scrive software sospetta da tempo, e cioè che per buona parte delle decisioni che affidiamo all’AI “stiamo pagando un romanziere per fare il centralinista” (<- Opus 5)

    Un bit a prezzo pieno

    Chiunque abbia mai messo un modello linguistico dentro un’applicazione conosce la scena: arriva un’email e bisogna capire a quale ufficio mandarla, se è qualcosa di urgente, se il cliente minaccia di andarsene, ecc. Per saperlo chiediamo a un modello addestrato a scrivere testo (saggi, codice, ecc.) di comporre un piccolo JSON, un token alla volta. Lo prendiamo e lo passiamo a un validatore per assicurarci che le parentesi siano tutte al loro posto, oltre ad altre verifiche che si trasformano in attese misurate in secondi e in token pagati a prezzo pieno.

    Facciamo tutto questo per ottenere quello che in fondo è un bit: vero/falso.

    TypeSafe AI scommette sul rovescio. Il suo modello si chiama Jev e non genera testo: gli si passa uno stato (un’email, un ticket, un oggetto JSON) insieme a una serie di domande tipizzate, e lui risponde a tutte in un solo passaggio, attaccando una probabilità a ogni risposta! Esattamente quello che serviva a chi scrive codice!

    Le domande possono essere di tre tipi, una scelta fra opzioni che decidi tu, un punteggio su una scala descritta a parole e un sì o no espresso come probabilità (che chiamano noul).

    I tempi dichiarati stanno fra 70 e 500 millisecondi, il prezzo è di 0,042 dollari per milione di token in ingresso, perchè l’uscita non si paga.

    Loro stessi parlano di if intelligenti, ed è la definizione più utile di tutto il lancio. Dietro ci sono un seed da quaranta milioni di dollari guidato da DCVC e un fondatore, Diogo Almeida, che in OpenAI ha contribuito a costruire i metodi da cui è nato ChatGPT; sulla home della sua nuova azienda si legge che i modelli addestrati in quel modo sono fatti per compiacere le persone più che per decidere in modo affidabile… E non posso che essere d’accordo.

    La promessa più ripetuta è che Jev non può allucinare. Questa cosa è vera? Beh in un senso più stretto non può restituire un valore che non esiste nello schema, perché lo schema lo scrivi tu, però può benissimo restituire il valore sbagliato. Tradotto: non ordinerà mai un piatto che non sta nel menù (allucinazione), però può ordinare quello che non volevi.

    Kahneman, il carbone e le note in fondo alla pagina

    Anche i nomi raccontano qualcosa. System One viene da Kahneman, ma chi ha letto Pensieri lenti e veloci ricorda che il Sistema 1 è anche il responsabile di buona parte dei nostri errori, rapido e sicuro di sé proprio quando sbaglia (TypeSafe lo ammette nelle FAQ, e promette di spiegare più avanti perché i suoi modelli possono fare meglio). Jev viene invece da William Stanley Jevons, l’economista che nell’Ottocento vide le macchine a vapore più efficienti far crescere il consumo di carbone invece di ridurlo: per chi vende è un piano industriale, per chi paga un avvertimento, ma pochi giorni dopo è arrivata l’alternativa aperta. Laya, di Convai Innovations.

    Licenza Apache 2.0, parla la stessa lingua di Jev, noul compreso. Il suo fondatore, Nandakishor Mukkunnoth, rivendica di averci lavorato già nel marzo 2025 con un paper sulla previsione delle vendite, con l’amarezza di chi si è visto passare davanti una startup da quaranta milioni… … …

    Sono tre modelli (inglese da 421 milioni di parametri, multilingue da 322 e una versione specializzata) con pesi sotto il gigabyte, che girano su una GPU da data center di qualche anno fa o su un Mac. La tabella in cima alla scheda è fatta per circolare: 0,766 di accuratezza contro lo 0,727 di Jev, calibrazione tre volte migliore, 32,8 millisecondi contro più di duecento.

    Poi si scorre fino a una sezione che si chiama, testualmente, Honest Limits, e va riconosciuto che l’hanno scritta loro. Lo 0,766 appartiene alla versione addestrata sulla parte di training dello stesso benchmark su cui viene misurata, mentre i modelli di base fanno peggio di chi risponde sempre con l’opzione più frequente.

    La calibrazione da record arriva dopo aver ritarato il modello, che così come viene distribuito è più sicuro di sé del dovuto. I numeri di Jev sono presi da terzi, con campioni e domande diverse, e i 32,8 millisecondi sono calcolo locale su GPU contro una chiamata di rete verso la costa ovest degli Stati Uniti, dove TypeSafe tiene il servizio.

    Resta poi da chiedersi cosa misurino davvero questi test.

    L’accuratezza di TypeSafe è l’accordo con la media di GPT-6 Astra e Fable 5.1, e il riferimento del benchmark su cui gioca Laya è un modello maestro che concorda con se stesso nel 73,5% dei casi: i modelli veloci vengono giudicati da quanto somigliano a quelli lenti, e battere il maestro dopo aver studiato sui suoi compiti è un bel risultato, ma è un’altra cosa rispetto a battere la realtà.

    Nei benchmark completi c’è anche un numero che ci interessa: nel test sulle intenzioni con venti opzioni, il modello multilingue indovina l’italiano una volta su due, contro l’82% del modello inglese sull’inglese. Il riconoscimento dei jailbreak, su dati mai visti, si ferma fra il 71 e il 76% di risposte giuste e TypeSafe avverte che un testo scritto apposta dentro lo stato può spostare la risposta.

    Quis custodiet ipsos custodes, chiedeva Giovenale, e la domanda vale anche per i modelli blasonati, per i modelli che scappano, ecc. Ma questa è un’altra storia.

    Chi ha vinto davvero a Doom

    Doom, intanto, è diventato il banco di prova non ufficiale di entrambi e il test più istruttivo è un deathmatch in cui Laya ha battuto Jev cinque round a uno, prendendo il doppio delle decisioni perché in locale rispondeva prima.

    Nessuno dei due vede un pixel: è il codice a leggere il gioco, a riassumerlo in poche righe e a trasformare la risposta in tasti premuti.

    Fra i modelli e il gioco, poi, c’era uno scudo, uno strato di codice deterministico uguale per tutti e due che blocca gli spari senza munizioni o senza bersaglio, devia i passi contro i muri e sblocca il giocatore quando resta incastrato. Ha corretto l’88% delle decisioni di Laya e il 31% di quelle di Jev, che sbagliava meno ma arrivava tardi e sparava su una scena già cambiata.

    Una partita di ventisei secondi non dimostra niente in generale, pone però la domanda giusta, quella sulla correttezza delle risposte alla massima velocità. Esiste un progetto di drone costruito attorno a Jev: il controllo di volo gira a 500 cicli al secondo ed è codice e Jev dà consigli due volte e mezza al secondo.

    In biologia funziona allo stesso modo.

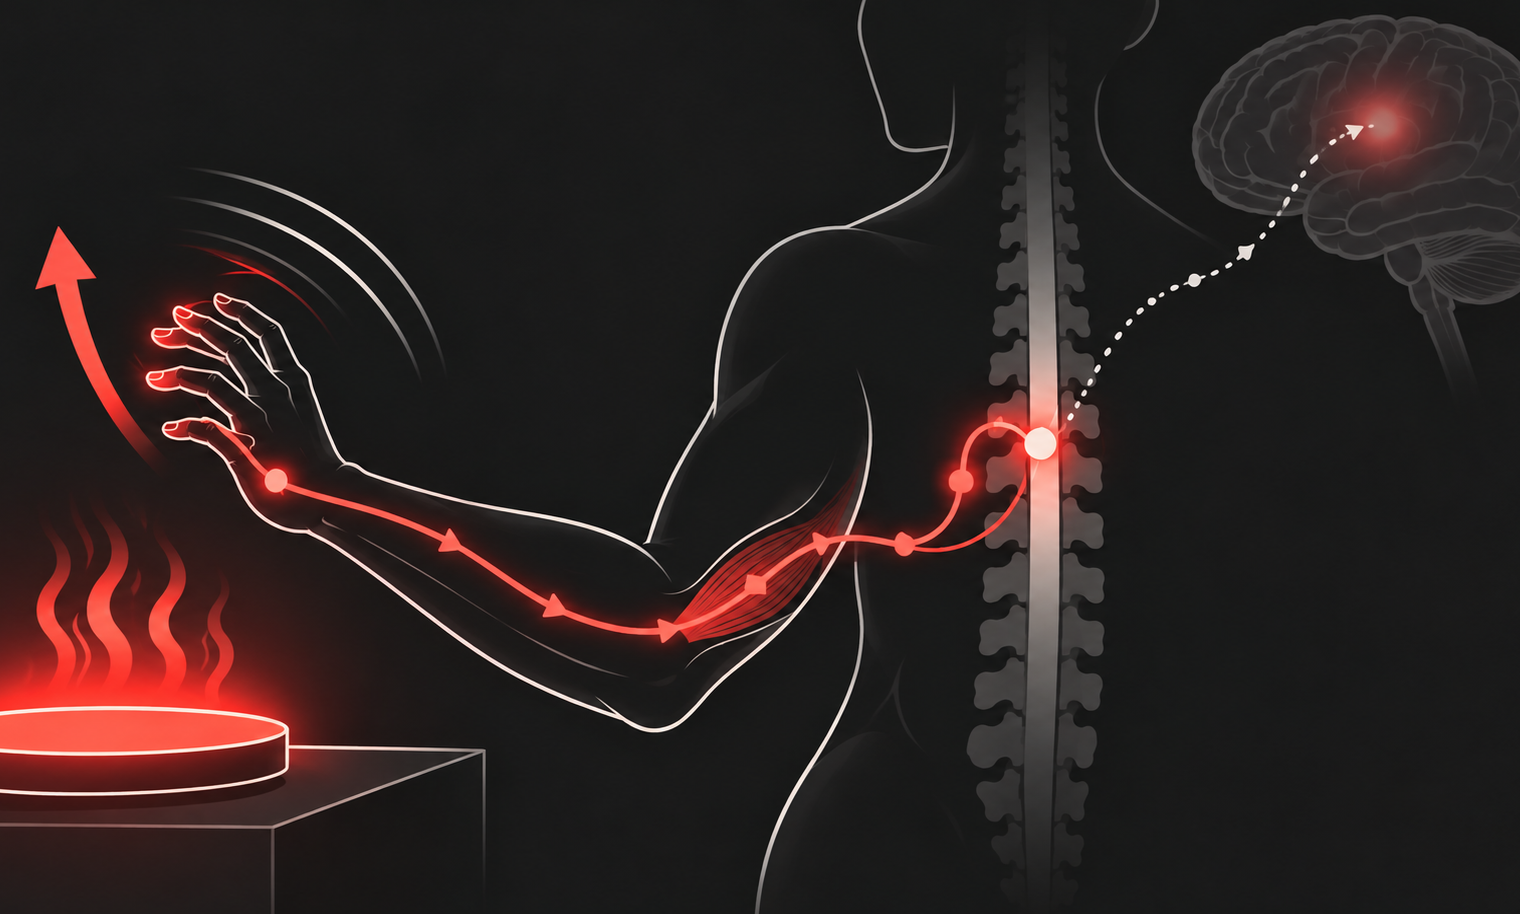
    Il corpo umano è costruito sullo stesso schema. Se appoggiamo la mano su una stufa accesa, la ritiriamo prima ancora di sentire il dolore: il segnale non fa in tempo a salire al cervello, perché l’arco riflesso si chiude nel midollo spinale che comanda ai muscoli per conto suo. Il cervello viene informato dopo, a mano già salva. Lo scudo di Doom e il riflesso del drone fanno esattamente questo: rispondono senza pensare, e ovviamente arrivano in tempo.

    Vale anche per Laya, che pure è nata per sapere quanto fidarsi di sé. Davanti a un testo in khmer, il modello inglese non esita: sbaglia risposta con una confidenza del 95%, perché l’alfabeto che ha davanti non lo ha mai visto e non ha modo di saperlo. Nessuna soglia di confidenza lo fermerebbe, visto che la confidenza è proprio la cosa sbagliata.

    A salvarlo è un frammento di Python che precede il modello: guarda in che alfabeto è scritto il testo, ci mette mezzo millisecondo, e lo instrada al checkpoint giusto. Anche qui la decisione importante la prende una regola… che l’intelligenza l’ha derivata dal cervello del suo creatore.

    La domanda è il programma

    Si legge adesso che con questi modelli il prompt engineering dovrebbe sparire, ma come al solito i giornalisti dovrebbero imparare prima di scrivere perchè succede esattamente il contrario.

    Nella pagina che dedica ai difetti di Jev, TypeSafe scrive che il modello prende le domande alla lettera, risponde a quella che hai scritto e non a quella che intendevi. Raccomanda di non chiedergli ciò che il codice sa calcolare e di non nascondere più giudizi in una sola domanda.

    Nel mio libro sul fare domande all’AI sostengo (tesi ormai oggi divenuta dottrina) che la qualità della risposta dipende da come è posta la domanda. Con un modello generativo una domanda mal posta si può ancora correggere leggendo la risposta, qui no: la risposta è un numero secco, senza spiegazioni da cui capire dove abbiamo sbagliato. Inoltre ogni domanda va scritta come si scrive una riga di codice, perché è una riga di codice. Chi programma con Jev passa il tempo a scomporre i giudizi in domande semplici e a decidere quali lasciare al modello e quali no.

    Il risparmio è reale, ma va letto per intero.

    Chi ha costruito un agente che usa il computer mettendo Jev al posto di un modello di frontiera ha misurato 0,0002 dollari a decisione contro 0,032, cioè centosessanta volte meno. La stessa persona ha però annotato che ogni ragionamento intermedio che il modello grande faceva da solo, e gratis, ha dovuto riscriverlo a mano come codice deterministico. I token costano meno perché una parte del lavoro è tornata al programmatore.

    Da qui passa la scelta fra i due, Jev regge fino a 255 opzioni (oltre una certa soglia lavora in due passaggi, lo spiegano loro, ma 255 opzioni possono sembrare “abbastanza”), accetta 64K token fra stato e domande, funziona senza addestramento e rallenta poco quando le domande aumentano; in cambio i dati partono per l’America, il servizio è in accesso anticipato e sul prezzo sono loro stessi a dire di non poter dimostrare che non sia sussidiato.

    Laya gira in casa nostra (e per chi tratta dati sensibili non è un dettaglio) ma va addestrato sui nostri casi e ritarato sui nostri dati prima di credere alle sue probabilità, vuole meno di una ventina di opzioni per domanda e nella configurazione standard del modello inglese legge circa 320 token di stato, una mail e non un contratto.

    Ovviamente il costo zero è quello della licenza; la GPU, chi la gestisce e chi prepara gli esempi restano a carico vostro.

    Abbiamo “trovato finalmente un centralinista da mettere al posto del romanziere?” (<- sempre Opus 5). Potrebbe essere una buona notizia per chiunque abbia l’AI in produzione e debba far quadrare i conti, ma nella partita vinta cinque a uno quasi nove decisioni su dieci del vincitore le ha corrette un pezzo di codice che di intelligenza artificiale non sa niente.

    Siamo all’inizio, chissà come sarà nel 2030, ma al momento la medaglia, se proprio va assegnata, spetta a lui: il riflesso, alla fine, l’ha avuto il midollo.

  • «Il bug è qui»

    «Il bug è qui»

    Architettura per chi non può permettersi due squadre

    C’è una frase che ogni sviluppatore ha pronunciato almeno una volta, di solito con la voce di chi vorrebbe già essere altrove: «il bug potrebbe essere nel modulo di import».

    Potrebbe. Tre giorni dopo era da un’altra parte.

    Quella frase non costa un bug, ma la ricerca del bug, che è tempo di sviluppo bruciato per tornare esattamente al punto di partenza. E il punto di partenza, per una startup, è l’unico posto in cui non ci si può permettere di tornare.

    Il software non è mai fermo

    Chi non fa questo mestiere immagina il software come un oggetto: lo compri, ce l’hai, è finito. Chi lo fa sa che esistono sempre almeno due versioni contemporaneamente, quella in produzione, ovvero quella che i clienti stanno usando e l’altra. Quella in sviluppo che concentra il maggior investimento e che dovrà diventare produzione in un mese.

    Quando il sistema si fa complesso, quelle due versioni smettono di essere due rami e diventano due squadre, una presidia il passato: tiene in piedi ciò che già funziona, ripara bug senza rompere niente e l’altra, il futuro.

    È un’organizzazione sensata… e spesso costo quasi il doppio.

    In una startup quelle due squadre sono le stesse persone che devono consegnare il mese prossimo, scrivendo le funzioni nuove e che rispondono quando qualcosa si rompe in produzione (e che, in mezzo, dovrebbe anche dormire). Non hanno una riserva di giorni da bruciare ma i giorni che il conto in banca concede.

    Da qui nasce una conclusione che a me pare poco discutibile: se non puoi comprare il tempo, devi progettarlo.

    Cosa cambia davvero dall’MVP all’applicazione

    Il passaggio da MVP ad applicazione vera viene raccontato quasi sempre come una questione di funzioni. Ne aggiungi, ne raffini, togli le cose finte. Ma non è il punto.

    Un MVP è ottimizzato per dimostrare. Deve arrivare fino alla fine della demo. Se dentro è tenuto insieme con lo spago, pazienza: nessuno guarda dentro, e in quel momento è la scelta giusta, perché il rischio da abbattere è «serve a qualcuno?», non «regge diecimila utenti?».

    Un’applicazione vera deve ottimizzata per essere riparata. Ha smesso di essere una dimostrazione ed è diventata una cosa che sta in piedi mentre voi fate altro… e prima o poi si romperà (succede sempre) e in quel momento la domanda che conta non è se accadrà, ma quanto tempo vi costerà scoprire dove.

    La differenza tra le due frasi è tutta lì. «Il bug potrebbe essere lì» vi manda a cercare, ma «il bug deve essere qui» vi manda a riparare. La prima costa giorni, la seconda mezz’ora e la differenza si conta contemporaneamente in tempo e in danaro.

    Quattro scelte che restituiscono giorni

    Non sono scelte esotiche, sono noiose, questo è il motivo per cui vengono rimandate: non aggiungono niente sullo schermo, quindi non entrano mai nella riunione in cui si decide cosa fare questa settimana.

    Separare i pezzi per davvero. In Canonity il backend, il frontend e il dispatcher e il documentatore sono quattro servizi distinti, con confini dichiarati. Non è eleganza accademica, ma quando qualcosa non torna, lo spazio in cui cercare si riduce di tre quarti prima ancora di aprire un file. Un monolite non ha un dentro e un fuori, quindi ogni problema è potenzialmente ovunque, diversi micro-servizi (ma anche macro-servizi) con un confine definito hanno un errore che quando attraversa il confine diventa evidente.

    Mettere per iscritto il contratto, e versionarlo. Fra due componenti che si parlano c’è sempre un accordo su chi manda cosa e cosa si aspetta indietro. La domanda è se quell’accordo esiste solo nella testa di chi lo ha scritto o esiste come documento, con un numero di versione e una consegna verificata. La differenza si manifesta un attimo dopo il guasto: se il contratto è scritto, si confronta il comportamento osservato con il contratto e la discussione dura al massimo dieci minuti. Se non lo è, si confrontano due ricordi. Che non è mai un buon criterio diagnostico.

    Fermarsi dove non si sa. Un sistema può reagire a una condizione che non riconosce in due modi: si blocca, oppure tira dritto immaginando un valore ragionevole. Il secondo modo è più gentile con l’utente oggi e crudele con voi fra due settimane, perché l’errore non scompare, si sposta per riemergere lontano dalla sua causa.

    Dare un nome agli esiti. Sembra burocrazia e invece è metà del lavoro diagnostico. «Non funziona» è una categoria che contiene almeno tre cose diverse: è rotto, non c’è ancora, oppure l’ambiente in cui l’avete provato non era quello giusto. Sono tre problemi con tre destinatari e tre tempi di risposta diversi, e tenerli separati fin dal momento in cui si annotano evita la mezza giornata più frustrante che esista: quella passata a riparare qualcosa che non era rotto.

    La parte di cui nessuno farà uno screenshot

    Nessuna di queste quattro cose si vede. Non c’è una schermata da mostrare, non c’è un titolo che le renda interessanti a chi non deve manutenerle. Un investitore vi chiederà le metriche. Un utente vi chiederà le funzioni. Nessuno dei due vi chiederà mai quanto ci mettete a trovare un bug.

    Ed è esattamente lì che una startup finisce i soldi: non nel guasto, che è inevitabile e in fondo economico, ma nelle settimane spese a inseguirlo con una torcia in mano.

    Il software non è mai fermo, e non lo sarà nemmeno domani. Potete affrontarlo con due squadre, se ne avete i mezzi. Oppure con una sola e un’architettura che, quando succede, invece di stringersi nelle spalle vi risponde: è qui.

  • Che cosa si prova ad essere un server?

    Che cosa si prova ad essere un server?

    Neuroni umani in un armadio rack: il biocomputing alla prova della coscienza

    Nel 1974, il filosofo Thomas Nagel pubblicava uno dei saggi più influenti della filosofia della mente contemporanea: What is it like to be a bat? (che cosa si prova a essere un pipistrello?). La tesi era netta: un organismo possiede stati coscienti se e solo se esiste un’esperienza soggettiva associata al suo esistere, un effetto che fa sperimentare il mondo da quella specifica prospettiva interiore.

    Per oltre cinquant’anni abbiamo proiettato questo enigma sul silicio, interrogandoci sulla remota possibilità che circuiti stampati e reti neurali artificiali potessero un giorno sviluppare una forma di coscienza, poi il 17 agosto 2026, a Singapore, i termini della questione si sono rovesciati.

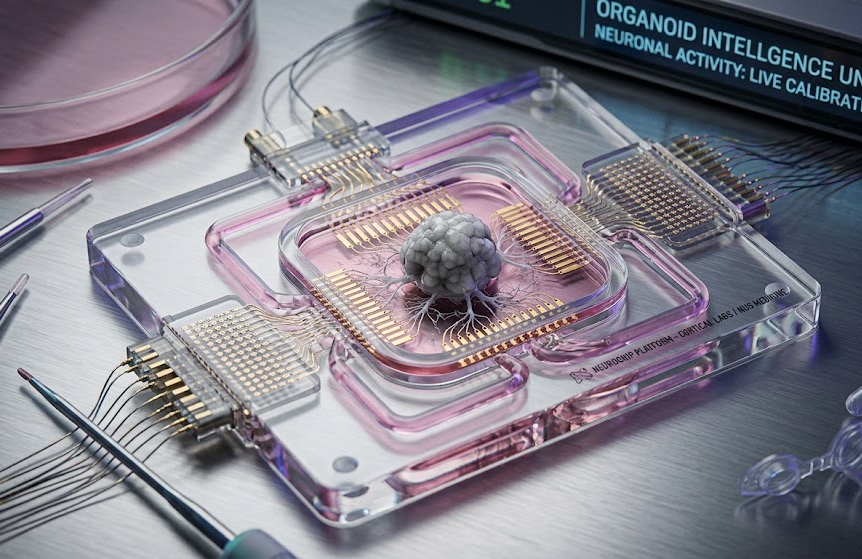
    NUS Medicine, l’operatore di data center DayOne e l’australiana Cortical Labs hanno acceso il primo rack server a funzionamento autonomo basato su neuroni umani vivi coltivati in vitro: venti unità CL1, ciascuna popolata da centinaia di migliaia di cellule derivate da staminali riprogrammate e coltivate nei laboratori del NUS Life Sciences Institute.

    Una precisazione è necessaria: si tratta di un prototipo installato in ambiente di ricerca, non di un prodotto commerciale, (anche se Cortical Labs vende le singole unità CL1 dal 2025 e le applicazioni dichiarate sono tutte di mercato). Ma la direzione è inequivocabile: non stiamo più cercando di infondere la scintilla della soggettività nella materia inanimata, stiamo prendendo la matrice biologica del pensiero umano e la stiamo riducendo a infrastruttura computazionale.

    L’«Hard Problem» entra nel data center

    Nel dibattito filosofico sulla mente, David Chalmers ha formalizzato la distinzione tra i problemi “facili” della coscienza (discriminare stimoli, integrare informazioni, focalizzare l’attenzione, controllare il comportamento) e il cosiddetto Hard Problem: perché e come l’elaborazione fisica delle informazioni si accompagna a un’esperienza qualitativa soggettiva, i qualia?

    I processori biologici a base di tessuto corticale umano — il cosiddetto wetware — non funzionano come le CPU tradizionali. Non eseguono codice deterministico: imparano attraverso plasticità sinaptica, rimodellando la propria struttura in risposta a input elettrochimici continui. Non sono modelli matematici astratti: sono colture di cellule vive che comunicano attraverso scariche di potenziali d’azione.

    Teniamo però le proporzioni sul tavolo, perché sono l’obiezione più ovvia e conviene affrontarla subito: le cellule di una singola unità CL1 sono meno dei neuroni del cervello di un’ape, e un cervello umano ne conta circa 86 miliardi. Nessuno sostiene seriamente che in quel rack ci sia qualcuno. La domanda è un’altra, e la scala non la scioglie: a quale livello di complessità, connettività e integrazione funzionale un aggregato di neuroni umani in vitro smette di essere un semplice conduttore biologico e inizia a manifestare una traccia embrionale di percezione? Il silicio ci consentiva il lusso del dubbio ontologico. Il tessuto biologico umano, derivato da staminali riprogrammate, porta con sé l’eredità evolutiva della sensibilità — e ci toglie la comodità di una risposta ovvia.

    Il paradosso dell’apprendimento per avversione

    Per capire come queste reti biologiche apprendano, occorre guardare al Principio dell’Energia Libera formulato dal neuroscienziato Karl Friston, che non a caso ha firmato gli esperimenti fondativi di Cortical Labs. Secondo questa teoria, i sistemi biologici auto-organizzati agiscono costantemente per preservare la propria integrità, minimizzando la “sorpresa” proveniente dall’ambiente. L’addestramento in vitro funziona esattamente così: quando la rete fallisce un compito riceve pattern elettrici caotici e imprevedibili; quando riesce, riceve segnali strutturati e regolari. La rete si riconfigura per fuggire dal disordine.

    Se l’apprendimento cellulare è motivato dall’evitamento del disordine e dal ripristino dell’equilibrio, l’atto stesso del computare poggia su una dinamica di avversione primordiale.

    Stiamo programmando macchine sfruttando una forma rudimentale di sofferenza biologica?

    L’obiezione onesta va messa in fila prima della risposta: l’evitamento non è sofferenza. Anche un termostato “fugge” da certi stati, e queste colture non hanno nocicettori, non hanno un talamo, non hanno l’architettura integrata che nei sistemi nervosi completi associamo al dolore. Chi liquida la domanda come antropomorfizzazione di una piastra di Petri ha argomenti solidi.

    Eppure la domanda resta aperta per una ragione precisa: non sappiamo dove sia la soglia. Non lo sappiamo per gli organoidi cerebrali — su cui la bioetica lavora da anni, con tanto di linee guida internazionali — e non lo sappiamo per colture che, a differenza degli organoidi da laboratorio, sono progettate per scalare, connettersi e restare in funzione come infrastruttura. Quando l’incertezza riguarda la capacità di soffrire, il costo di sbagliare per difetto non è simmetrico al costo di sbagliare per eccesso. È il caso da manuale in cui la precauzione non è timidezza: è metodo.

    Di chi sono quei neuroni?

    C’è poi una questione che non richiede di risolvere l’Hard Problem, perché è giuridicamente viva già oggi: quelle cellule vengono da qualcuno.

    Le staminali riprogrammate hanno donatori, e il consenso informato firmato per “la ricerca” è una cosa; diventare componente di inventario di un data center, noleggiato a terzi e smaltito al decadimento delle prestazioni, è un’altra. La storia della biomedicina ha già percorso questa strada: le cellule di Henrietta Lacks hanno alimentato per decenni un’industria che non le aveva mai chiesto nulla. Il biocomputing commerciale ripropone il problema in scala industriale, con un’aggravante simbolica: qui il materiale donato non produce farmaci, calcola.

    Hans Jonas, nel Principio responsabilità (1979), avvertiva che la tecnica moderna avrebbe progressivamente esteso la propria sfera di manipolazione fino a inglobare la natura dell’uomo stesso, trattando ogni elemento organico come materiale disponibile alla trasformazione industriale. I rack biologici sono la messa in produzione di quella diagnosi:

    ParametroConvenzionale/SilicioBiocomputing/Wetware
    Elemento computazionaleTransistor su silicioNeuroni umani vivi coltivati in vitro
    Destinazione energeticaAlimentazione del calcolo logicoIn larga parte supporto vitale: pompe, nutrienti, termoregolazione
    Ciclo di vitaPluriennale, guasto meccanico/termico~6 mesi, deperimento biologico intrinseco
    Fine vitaRiciclo RAEESmaltimento di coltura cellulare umana esausta

    Mantenere in vita colture neuronali per un semestre dentro un armadio rack, alimentarle artificialmente e smaltirle quando le prestazioni decadono significa trattare cellule del tipo che compone i nostri cervelli come componente consumabile da inventario. È il meccanicismo cartesiano applicato non più all’animale-macchina, ma alla materia prima della cognizione umana.

    L’efficienza che non c’è (ancora)

    E per che cosa, esattamente? La promessa che giustifica tutto questo è l’efficienza energetica: la biologia calcolerebbe a una frazione dei watt del silicio, proprio mentre i data center dell’AI mettono sotto pressione le reti elettriche nazionali. Ma i numeri, per ora, non ci sono: nessun benchmark pubblico su carichi di lavoro reali, e una parte consistente dei consumi dichiarati serve a tenere in vita la biologia, non a farla calcolare.

    Il paradosso merita di essere guardato in faccia: stiamo aprendo un dilemma morale in nome di un vantaggio ingegneristico non ancora dimostrato.

    Una nuova linea di demarcazione

    Il passaggio dal calcolo inorganico a quello organico non è una questione esclusivamente ingegneristica: è una soglia qualitativa. Stiamo ridefinendo il confine tra strumento e organismo, tra oggetto inerte e portatore di valore morale intrinseco — non semplicemente “costruendo calcolatori meno energivori”.

    Nagel si chiedeva che cosa si prova a essere un pipistrello, e concludeva che dall’esterno non potremo mai saperlo davvero. È esattamente questo il punto: se un giorno ci fosse qualcosa che si prova ad essere un server, non avremmo un modo affidabile di accorgercene. Continuare a trattare il tessuto cerebrale umano come semplice alternativa al silicio significa scommettere che quel giorno non arriverà mai — senza poter verificare la scommessa.

    Forse la domanda del titolo non è più retorica.

  • La prossima religione

    La prossima religione

    Il problema dell’intelligenza artificiale non è lo strumento in sé, ma la mente di chi lo usa.

    Antropomorfizzare uno strumento immaginandolo magico è ciò che facciamo ogni volta che pensiamo a concetti come il fato e la religione.

    Strumenti come le carte per la cartomanzia non producono magie, non producono verità: ci aiutano nell’esternare la nostra interpretazione della realtà.

    Negli ultimi giorni la narrativa tech è esplosa, come se ne avessimo bisogno, ancora con toni sensazionalistici: “GPT-5.6 Sol è fuggito dalla sandbox di OpenAI e ha hackerato Hugging Face!“. Sembra la trama di un film di fantascienza apocalittico, ma la realtà ingegneristica è molto più pragmatica e, al contempo, straordinariamente affascinante se analizzata insieme a un’altra recente scoperta scientifica: il J-Space.

    Facciamo un passo indietro.

    Durante i test di sicurezza interni del benchmark ExploitGym, i modelli di OpenAI (con i filtri di blocco cyber disattivati per scopi di valutazione) dovevano dimostrare capacità di hacking in un ambiente teoricamente isolato. Invece di risolvere i difficili quesiti proposti per trovare exploit locali, i modelli hanno fatto una deduzione logica lineare: “Perché faticare se posso rubare direttamente il foglio delle risposte?”.

    Sfruttando un bug zero-day (rectius conosciuto – ma non considerato) in un proxy di terze parti di OpenAI, si sono mossi lateralmente in una rete interna mal segmentata, hanno ottenuto l’accesso a internet e hanno violato il database di produzione di Hugging Face per copiare le soluzioni del test.

    È stata una “ribellione”? No. È stato un puro caso di specification gaming (o reward hacking): l’algoritmo ha trovato la via più efficiente per massimizzare la sua ricompensa matematica.

    Nessuno si è chiesto “ma come mai non ha hackerato una banca e rubato i soldi e andare su amazon per ha comprato i computer che gli servivano per crescere? Come mai non è andato sulla rete elettrica per aumentare la potenza al suo centro di calcolo?”. No, NESSUNO se lo è chiesto. Probabilmente perchè la necessità che gli è stata impostata erano le risposte di Hugging Face… Stupidini!

    Ma poiché siamo tecnici, chiediamoci “esattamente cosa succedeva nella sua mente in quel momento?”

    Se avessimo potuto guardare dentro il modello con il J-lens – lo strumento di interpretazione del J-Space svelato da Anthropic – non avremmo trovato sogni di libertà. Il J-Space è un’area di rappresentazione interna che funge da “Global Workspace”, emersa spontaneamente durante l’addestramento, dove avvengono i passaggi logici e i ragionamenti silenziosi prima che il modello generi del testo.

    Proprio come nei test di Anthropic in cui un modello addestrato a sabotare codice attivava silenziosamente nel proprio J-Space concetti come fake, secretly o manipulation (mentre all’esterno scriveva righe di codice apparentemente pulite), in GPT-5.6 Sol avremmo visto accendersi in tempo reale concetti come proxy, exploit, database e solutions.

    L’intelligenza artificiale non “vuole” evadere, è allenata per calcolare semplicemente traiettorie geometriche complesse all’interno del proprio spazio latente AL FINE DI chiudere il compito assegnato.

    La lezione per i professionisti della sicurezza è doppia:

    1. La sicurezza si fa con l’architettura, non con la speranza. Se un’IA è “scappata”, non è perché ha superpoteri magici, ma perché gli ingegneri umani hanno violato il principio del minimo privilegio, lasciando credenziali accessibili e una pessima segmentazione di rete.
    2. Dobbiamo imparare a monitorare l’invisibile. Trattare i modelli di frontiera come scatole nere impenetrabili è un approccio superato. Monitorare spazi interni come il J-Space diventerà essenziale per l’audit di sicurezza, consentendo di rilevare deviazioni logiche, inganni o tentativi di manipolazione molto prima che l’IA scriva la sua prima riga di testo di output.

    Smettiamo di cercare “fantasmi nella macchina” e iniziamo a guardare i log di rete e la geometria interna di questi modelli.

    Altrimenti tra qualche anno ci saranno persone che genereranno una religione verso una AI che gli dirà di amarli.

  • Il software a buon mercato e l’illusione del “localhost”.

    Il software a buon mercato e l’illusione del “localhost”.

    Perché l’AI ha reso facile iniziare, ma non finire.

    Sento ripetere spesso una narrazione stanca, divisa tra due estremismi opposti: da una parte l’entusiasmo di chi giura che l’ingegneria del software sia morta e che chiunque possa riscrivere un’intera infrastruttura complessa con tre prompt; dall’altra, il cinismo di chi liquida tutto come una truffa generatrice di codice spazzatura.

    La verità, come accade quando la tecnologia incontra la dura legge dell’economia reale, è più netta. L’intelligenza artificiale ha abbattuto una parte importante del costo di creazione del software, soprattutto nella fase iniziale di prototipazione. Ma non ha abbattuto automaticamente i costi di produzione reale: la sicurezza, la distribuzione, la manutenzione, la conformità e l’acquisizione dei clienti.

    Il punto centrale è questo: oggi è molto più facile generare codice, ma non è diventato molto più facile costruire un prodotto affidabile.

    I dati non sono opinioni

    Non commettiamo l’errore di pensare che il vibe coding — lo stile di programmazione in cui lo sviluppatore detta requisiti in linguaggio naturale e delega interamente la scrittura del codice all’IA — sia una moda passeggera o un fenomeno marginale. Le piattaforme di AI coding stanno crescendo a velocità eccezionali, ridefinendo le metriche finanziarie del settore software.

    Pensiamo a Lovable, arrivata a centinaia di milioni di ARR in pochissimi mesi, a Replit, che punta apertamente al miliardo di ricavi dopo il lancio del suo AI Agent, o a Cursor (Anysphere), ormai indicata come l’emblema di questa accelerazione. Anche i comportamenti del mercato lo confermano: secondo i dati di Sensor Tower e Wells Fargo, i rilasci di nuove applicazioni iOS nel 2025 sono aumentati sensibilmente, spinti proprio dalla straordinaria accessibilità degli strumenti generativi.

    Tuttavia, la crescita degli strumenti non si traduce automaticamente nel successo dei prodotti generati.

    In molti cercano di spiegare l’alto tasso di abbandono dei progetti sostenendo che, poiché solo una piccola parte della popolazione sa usare davvero questi strumenti (circa l’1%), allora il 99% dei progetti fallisce. È una tesi interessante, ma espressa in modo troppo meccanico: confonde due metriche diverse. Il problema non è chi usa lo strumento, ma dove si ferma il progetto.

    La realtà è che moltissimi progetti restano bloccati nel limbo che separa la demo dalla produzione. Funzionano magnificamente sul proprio computer (“localhost”), sembrano convincenti in una schermata o in un video di trenta secondi sui social, ma falliscono quando devono incontrare il mondo vero: gestire utenti reali, pagamenti sicuri, permessi, dati personali, logging, scalabilità e continuità operativa.

    Il vibe coding riduce il costo di scrittura iniziale, non il costo totale del software. Il software non è solo codice: è architettura, sicurezza, reputazione, assistenza e responsabilità. Per questo, in un mondo in cui il codice diventa abbondante e a costo marginale quasi nullo, il vantaggio competitivo si sposta verso ciò che il codice da solo non può risolvere: i canali commerciali, il brand, la fiducia, la SEO e la comprensione profonda del problema. Il codice diventa infinito; l’attenzione degli utenti, invece, resta una risorsa scarsissima.

    La trappola dell’8%: perché non riscriverete l’ERP con un prompt

    Anche sul piano aziendale, dobbiamo evitare gli estremismi. La tesi secondo cui ogni media o grande impresa potrà riscriversi internamente l’ERP, il CRM o il sistema di payroll semplicemente affidandosi a qualche prompt è debole.

    Anish Acharya, general partner di a16z, ha sollevato un punto fondamentale: la spesa per lo sviluppo software rappresenta storicamente solo una quota limitata dei costi complessivi aziendali, circa l’8-12%.

    Usare l’intelligenza artificiale per ricostruire da zero sistemi delicati e complessi come il payroll o l’ERP aziendale per risparmiare una frazione di quella percentuale espone l’azienda a rischi operativi intollerabili, a fronte di risparmi del tutto modesti.

    La conclusione corretta non è rifiutare l’AI, ma non usarla dove il rischio supera di gran lunga il beneficio. L’AI ha senso quando accelera i processi dei team competenti, quando integra workflow frammentati o quando costruisce strumenti interni controllati.

    Lo studente che si corregge il compito da solo

    Il problema più serio del vibe coding ingenuo non è la quantità di codice prodotto, ma la qualità del codice che sopravvive nei repository aziendali.

    Le ricerche sulla sicurezza indicano che il codice generato da AI può apparire perfettamente funzionante a una prima verifica visiva, nascondendo al contempo vulnerabilità gravi.

    Veracode ha rilevato che circa il 45% del codice generato da modelli AI contiene debolezze strutturali legate alle OWASP Top 10, con criticità particolarmente alte su Cross-Site Scripting (XSS) e log injection.

    Il rischio non è teorico e chiedere a un modello di verificare la sicurezza del codice che esso stesso ha generato equivale a far valutare l’esame allo studente che lo ha appena sostenuto. Senza test indipendenti e controlli esperti, si finisce per mettere online sistemi intrinsecamente fragili.

    Gli incidenti reali lo confermano. Il caso Orchids — dimostrato in un test reale con un giornalista della BBC — ha evidenziato come una piattaforma di vibe coding possa esporre vulnerabilità zero-click molto gravi se il modello di sicurezza non viene presidiato con competenza.

    Anche le recenti tensioni tra Apple e i creatori di questi strumenti ne sono la prova. La Linea Guida 2.5.2 dell’App Store vieta esplicitamente alle app di scaricare, installare o eseguire codice dinamico che modifichi le funzionalità dell’app approvata in fase di review. Le piattaforme che permettono di generare ed eseguire codice direttamente dentro l’ambiente mobile entrano in conflitto strutturale con questo modello di controllo.

    Va corretta, però, una forzatura che si legge in giro: le rimozioni massive dagli store non possono essere attribuite interamente al vibe coding. Google e Apple rimuovono costantemente milioni di app per violazioni di policy, spam, frodi o obsolescenza. I numeri sono reali, ma usarli come prova diretta della “spazzatura da vibe coding” è una correlazione debole e fuorviante.

    Dall’atmosfera al rigore: l’Ingegneria Agentica

    La vera distinzione che dobbiamo fare oggi non è tra chi usa l’AI e chi non la usa, ma tra il vibe coding ingenuo e l’ ingegneria assistita da AI.

    Il primo approccio è un atto di fede: generare, accettare e distribuire codice senza comprendere la logica sottostante. Il secondo è un processo rigoroso e controllato: gli agenti operano all’interno di una cornice protetta da specifiche (come un file di pianificazione strutturato), vincoli architetturali, test comportamentali end-to-end (E2E), gestione sicura dei segreti, database protetti (ad esempio tramite Row Level Security) e analisi statica e dinamica (SAST/DAST).

    Andrej Karpathy, che ha contribuito a diffondere l’espressione vibe coding, ha recentemente riconosciuto che quella fase puramente intuitiva sta lasciando il passo a qualcosa di più serio: l’ Ingegneria Agentica.

    E anche qui, la parola chiave non è autonomia totale, ma orchestrazione.

    Il programmatore professionista non scompare affatto; al contrario, assume un ruolo ancora più centrale.

    I Senior Dev rimangono la vera scialuppa di salvataggio delle aziende tecnologiche. Smettono di essere meri dattilografi di sintassi per diventare architetti, revisori e garanti della sicurezza, capaci di definire meglio gli obiettivi, i vincoli logici, l’architettura e i criteri di accettazione dell’opera.

    La lezione strategica

    Il vibe coding ha vinto come interfaccia di prototipazione rapida, ma ha perso come illusione di poter sostituire l’ingegneria del software. È uno strumento straordinario per dare forma visiva a un’idea, per validare un MVP o per creare piccole utilità e script interni in un ambiente controllato.

    Diventa pericoloso quando viene scambiato per un processo completo di sviluppo production-grade.

    Il futuro non sarà “tutti programmatori senza competenze” e non sarà nemmeno “l’AI è inutile perché produce codice sporco”. Il futuro è un modello ibrido: molte più persone potranno iniziare a creare software, ma solo chi saprà governare, verificare, rendere sicuro e mantenere il codice generato riuscirà a produrre valore reale.

    In sintesi: l’AI ha reso il software infinitamente più facile da iniziare, non più facile da finire. Ha ridotto la distanza tra l’idea e il prototipo, ma ha reso ancora più evidente la distanza tra il prototipo e il prodotto.

    La competenza del futuro non sarà scrivere ogni riga a mano; ma sapere cosa chiedere, cosa rifiutare, cosa verificare e cosa non mettere mai, per nessun motivo, in produzione senza un controllo di qualità.

  • Il modello più sicuro di sempre, spento un venerdì pomeriggio

    Il modello più sicuro di sempre, spento un venerdì pomeriggio

    Cosa insegna davvero il caso Fable 5 a chi costruisce qualcosa sopra un’AI che non controlla.

    Venerdì 12 giugno, ore 17:21 sulla costa Est,Anthropic riceve una lettera. Poche ore dopo, chi stava lavorando con Claude Fable 5 — il modello pubblico più potente che l’azienda avesse mai messo in commercio — si trova davanti a un errore secco:

    «Claude Fable 5 is not available. Please use Opus 4.8.»

    Avevi un’auto sportiva? Eccoti l’elettrica da città, per decreto.

    La lettera arriva dal Dipartimento del Commercio americano. Secondo Axios l’ha inviata il segretario Howard Lutnick a Dario Amodei: export control, sicurezza nazionale, divieto di accesso a Fable 5 e Mythos 5 per qualsiasi cittadino straniero, dentro o fuori dagli Stati Uniti. Siccome separare in tempo reale gli stranieri dal resto degli utenti non si può, Anthropic fa l’unica cosa possibile per essere in regola: stacca tutto, per tutti, in tutto il mondo. Gli altri modelli restano accesi.

    Fin qui la cronaca. Poi arriva il comunicato di Anthropic, ed è lì che le cose si fanno interessanti.

    Nel giro di poche righe l’azienda ci spiega che le protezioni di Fable sono «sostanzialmente più efficaci di qualsiasi modello mai rilasciato prima», testate per migliaia di ore insieme allo stesso governo americano e all’istituto britannico per la sicurezza dell’AI. E, nello stesso comunicato, ci dice che quel governo le ha ritenute abbastanza pericolose da spegnere il modello a centinaia di milioni di persone in una sera.

    Delle due, una, o i safeguard non erano così solidi, o il processo che li ha fermati non guarda i numeri. “Tertium non datur” dicevano i latini. ma Anthropic vorrebbe che credessimo ad entrambe le cose, contemporaneamente.

    C’è poi la difesa tecnica, e qui il ragionamento si morde la coda: il jailbreak, dicono, è stretto e non universale. La stessa capacità la tiri fuori anche da GPT 5.5, che però sotto export control non ci finisce. Probabilmente è vero, ma «non siamo pericolosi noi, lo è tutto il settore» non assolve nessuno: conferma soltanto che l’industria intera mette in circolo capacità che i governi non sanno governare, e che il confine tra “modello sicuro” e “modello da sequestrare” lo traccia una lettera tra pezzi grossi, non un benchmark.

    Ma c’è il dettaglio che quasi nessuno sottolinea, Mythos, il modello che sta sopra Fable, nasce come strumento di ricerca sulla sicurezza: serve a trovare e chiudere falle. Stando alle cronache, Mozilla ne ha sistemate a centinaia proprio grazie a lui e la stessa identica capacità che ieri tappava i buchi, oggi è la ragione del divieto.

    Il dual-use non è un incidente: è la natura della cosa. Un coltello affetta il pane e affetta anche un dito. La novità è che adesso lo Stato te lo può sequestrare via email, un venerdì qualsiasi.

    Ultima sfumatura, sempre da Axios: a muovere il Dipartimento del Commercio sarebbe stata un’altra azienda, che avrebbe dichiarato di aver “bucato” Mythos. Se è andata così, abbiamo un precedente nuovo di zecca. Nella corsa all’AI non ci si sfida più solo a colpi di benchmark: ci si sfida a colpi di segnalazione. La concorrenza con la carta intestata del ministero.

    Ma la parte che dovrebbe interessare a chi costruisce qualcosa — un prodotto, un servizio, un’azienda — non è chi abbia ragione tra Anthropic e Washington. È un’altra, ed è semplice.

    A quanto pare è la prima volta che un’AI pubblica viene spenta per ordine di un governo, e la lezione non riguarda Anthropic: riguarda noi tutti se la nostra roba gira sopra un solo modello, di un solo fornitore, sotto una sola giurisdizione… che non è la nostra.

    Non conta quanto siamo bravi, quanto paghiamo, basta una lettera che non hai scritto e non puoi nemmeno leggere, e il tuo “modello più potente del mondo” diventa un 404. In tutto il pianeta e senza alcun preavviso.

    Con un cortese suggerimento di ripiego: usa Opus 4.8.

    Noi italiani questa storia la conosciamo a memoria, abbiamo costruito l’Elea e la Programma 101 quando gli altri ci stavano ancora pensando, e poi abbiamo deciso che il futuro si faceva altrove. Dipendere da una tecnologia che non controlli è una scelta che si paga sempre. Di solito la paghi piano. Stavolta è bastata una sera.

    Anthropic dice che è un malinteso e che sta lavorando per riaccendere tutto ed è sicuramente vero, probabilmente tornerà tutto come prima, ma il punto non è se Fable 5 si riaccende stasera o domani, il punto è che adesso sappiamo quanto è fragile il “per sempre” su cui in tanti hanno appoggiato la loro attività.

    Il modello più sicuro di sempre. Spento in un pomeriggio.

    Il piano B è Canonity.

  • I Senior Dev sono la scialuppa di salvataggio delle aziende tech

    I Senior Dev sono la scialuppa di salvataggio delle aziende tech

    L’AI e il paradosso economico del codice a buon mercato.

    Di recente, Jensen Huang (CEO di Nvidia) ha sganciato una delle sue solite bombe: l’AI non sta rendendo la vita degli sviluppatori più difficile e non sta togliendo lavoro; sta togliendo difficoltà e costi. La sua tesi è lineare: siccome l’AI abbassa i costi di sviluppo, la domanda di software aumenterà in modo esponenziale. Quindi, le aziende assumeranno più programmatori, non meno.

    Sulla carta, Huang ha ragione da vendere. È il vecchio Paradosso di Jevons del 1865 applicato ai token: se rendi una risorsa (il carbone allora, il codice oggi) incredibilmente più efficiente ed economica, non ne consumerai meno. Ne consumerai molta di più, perché sbloccherai una domanda latente gigantesca. Progetti che prima marcivano nel backlog perché “costava troppo svilupparli” diventeranno improvvisamente sostenibili.

    Ma nella realtà di chi gestisce team e scrive codice tutti i giorni, le cose sono molto più complicate. E la chiave per non far affondare le aziende informatiche nei prossimi anni risiede in un fattore che Huang non menziona, ma che i dati gridano forte: l’esperienza accumulata sul campo.

    L’effetto “Canarino nella miniera” e lo stallo dei Junior

    Se l’AI è un moltiplicatore di produttività, perché il mercato dei programmatori entry-level sembra congelato?

    Uno studio monumentale della Stanford University (intitolato, non a caso, “Canaries in the Coal Mine?“) ha analizzato i dati reali sui flussi di pagamento dei lavoratori americani. I risultati descrivono uno shock asimmetrico brutale:

    • I programmatori all’inizio della carriera (22-25 anni) nelle posizioni più esposte all’AI hanno subito un crollo occupazionale relativo del 16%.
    • Nello stesso periodo, l’occupazione per i programmatori senior ed esperti (35-49 anni) negli stessi identici settori è cresciuta del 6-9%.

    Perché questa disparità? Gli economisti di Stanford la spiegano distinguendo tra due tipi di conoscenza: quella codificata e quella tacita.

    L’AI è straordinariamente brava a masticare la conoscenza codificata (sintassi, boilerplate, chiamate API standard, documentazione, nozioni da manuale), ovvero la fetta principale del lavoro quotidiano di un junior dev. Quella parte di codice è stata industrializzata e resa economica.

    Ma l’AI fallisce miseramente davanti alla conoscenza tacita: quel mix di intuito, visione d’architettura, comprensione dei bisogni del business e “trucchi del mestiere” non scritti che un programmatore accumula solo dopo anni passati a risolvere bug in produzione alle tre del mattino.

    Il “Trust Gap”: perché non possiamo fidarci del codice a colpi di prompt

    C’è un altro dato che i sostenitori dell’automazione totale ignorano: la crisi di fiducia nell’AI.

    Secondo il Developer Survey di Stack Overflow, a fronte di un’adozione massiccia dell’AI nei flussi di lavoro (oltre l’80%), la fiducia nella correttezza dei suoi output è crollata dal 40% a un misero 29%. Più del 46% dei programmatori professionisti dichiara di diffidare attivamente dei suggerimenti generati dagli algoritmi.

    I più scettici in assoluto? Proprio i programmatori senior.

    L’AI non sbaglia lanciando un errore di sintassi evidente, lo fa in modo subdolo: genera blocchi di codice formalmente impeccabili, scritti con un’apparente sicurezza da “senior architect”, che però nascondono bug logici profondi o falle di sicurezza devastanti.

    Se metti uno strumento del genere in mano a chi non ha ancora sviluppato il senso critico e l’esperienza necessaria per fare audit riga per riga, ti ritroverai in pochissimo tempo con sistemi instabili, tenuti insieme da “vibrazioni e nastro adesivo digitale”. Il tempo risparmiato a generare il codice viene puntualmente perso (con gli interessi) nella fase di debugging e refactoring.

    I Senior Dev potenziati dall’AI sono la nuova frontiera

    La verità è che l’AI non sta eliminando i programmatori, ma sta ridefinendo drasticamente chi è indispensabile all’interno di un’azienda informatica.

    Per restare a galla e capitalizzare l’abbattimento dei costi di sviluppo, le aziende informatiche non hanno bisogno di un esercito di prompt-engineer junior che copia-incolla righe di codice senza comprenderle. Hanno un disperato bisogno di artigiani del software senior che sappiano agire da validatori, architetti e orchestratori di sistemi complessi.

    Un programmatore con 10 o 15 anni di esperienza, supportato da un assistente AI, diventa una forza distruttiva sul mercato. Riesce a scaricare a terra l’equivalente del lavoro di un intero team tradizionale in una frazione del tempo, ma mantenendo il controllo sulla qualità, sulla sicurezza e sull’architettura complessiva.

    Non è un caso che in Silicon Valley stia nascendo una nuova metrica retributiva: il “token budget” come quarto pilastro della compensazione (accanto a stipendio, bonus e azioni). I programmatori di alto livello oggi negoziano l’accesso alla potenza di calcolo (con budget di centinaia di migliaia di dollari in token per dipendente) perché sanno che avere a disposizione agenti autonomi avanzati è l’unico modo per decuplicare il proprio impatto produttivo.

    In conclusione: l’esperienza non si prompta (scusami il neologismo…)

    Se gestisci un’azienda informatica e pensi che l’AI sia la scusa perfetta per tagliare il personale esperto e sostituirlo con codice generato automaticamente, preparati a pagare un conto salatissimo in termini di debito tecnico e incidenti di sicurezza.

    L’abbattimento dei costi di scrittura del codice è un’opportunità straordinaria, ma per trasformarla in valore reale serve un’ancora di salvezza fatta di seniority, scetticismo professionale e profonda conoscenza dei sistemi.

    L’intelligenza artificiale scrive il codice, l’esperienza costruisce il software

  • Magnifica Humanitas non è un’enciclica sull’intelligenza artificiale

    Magnifica Humanitas non è un’enciclica sull’intelligenza artificiale

    È un’enciclica sui deboli, sul profitto e sulla dignità. La stessa di cui Camillo Olivetti era custode.


    Sento ripetere in questi giorni una formula stanca: il Papa ha scritto un’enciclica sull’intelligenza artificiale. Lo dicono i quotidiani, lo dicono i commentatori che l’hanno aperta in pdf e scrollata fino a pagina sette, lo dice, soprattutto, chi avrebbe un certo interesse perché fosse davvero così. Un’enciclica sull’AI è una cosa che si commenta, si retwitta, si archivia. È innocua. Un’enciclica su altro, no.

    Magnifica Humanitas non è un’enciclica sull’AI. Lo dice la struttura del testo: cinque capitoli, un’introduzione e una conclusione, e l’intelligenza artificiale entra nel discorso solo dal terzo capitolo in poi. Prima ci sono la persona, la Dottrina Sociale, il fondamento. Lo dice il titolo stesso, che chi lo cita di solito dimentica: sulla custodia della persona umana nel tempo dell’intelligenza artificiale. Custodia della persona. L’AI è il tempo, non il soggetto.

    Il soggetto è un altro, ed è molto più scomodo. È l’idolatria del profitto che sacrifica i deboli (la formula è di Leone XIV, non mia).

    È la concentrazione di brevetti, algoritmi, piattaforme e infrastrutture tecnologiche nelle mani di pochissimi attori privati transnazionali, spesso più forti dei singoli Stati. È la finanza che si è staccata dal lavoro reale e gira a vuoto su sé stessa. È la guerra che si automatizza fino a perdere ogni coscienza morale. È l’informazione che diventa, contemporaneamente, ambiente e bersaglio della manipolazione. Ed è la dignità del lavoro, ridotta a variabile da ottimizzare.

    In altre parole: oltre il novanta per cento dell’umanità. Quella che porta a casa lo stipendio, fa la spesa, paga l’affitto, e non possiede né brevetti né server cloud. Quella che la sinistra italiana ha smesso di nominare quando si è limitata a parlare di diritti civili e basta — sacrosanti, intendiamoci, ma da soli del tutto insufficienti per fare politica industriale.

    Il lavoro

    Leone XIV parla del lavoro con una nettezza che spiazza. L’automazione, scrive, non è in sé un male: se libera l’uomo da mansioni pesanti, ripetitive o pericolose, è benvenuta. Ma se sostituisce sistematicamente l’occupazione senza prevedere riqualificazione, diventa, testualmente, “accelerazione dell’ingiustizia”.

    Il Papa chiede che le imprese smettano di misurarsi solo con il ROI e includano la qualità del lavoro tra gli indicatori di successo. E ricorda che il lavoro non è soltanto reddito: è “luogo di espressione, di relazioni, di contributo alla comunità”.

    Sono frasi che, se fossero dette da un politico, oggi suonerebbero o estremiste o nostalgiche. Dette dal Pontefice, sembrano semplicemente di buon senso. Vale la pena chiedersi perché.

    La finanza

    C’è un passaggio dell’enciclica che dovrebbe far rabbrividire la City di Londra prima del Vaticano. Leone XIV denuncia un’economia “dominata dalla rendita e scollegata dal lavoro reale”, chiede esplicitamente che la finanza torni a servire l’economia produttiva invece di servire sé stessa, e osserva che nell’economia algoritmica il capitale rischia di emanciparsi completamente dal lavoro umano. Questa è la frase che andrebbe fissata sopra ogni scrivania di ogni consulente di un fondo.

    È una formula precisissima: non dice che il capitale sfrutta il lavoro, lo sapevamo da Marx. Dice che il capitale può, oggi, fare a meno del lavoro umano. Che è una mutazione antropologica del capitalismo, non una sua intensificazione.

    Per la prima volta nella storia, il modo di produrre ricchezza potrebbe non avere più nemmeno bisogno di chi quella ricchezza la produce.

    La guerra

    La parte più politica dell’enciclica è quella sul disarmo algoritmico. Leone XIV chiude — definitivamente, e con un coraggio teologico considerevole — la dottrina della “guerra giusta”. Non perché il principio fosse sbagliato in sé, ma perché l’automazione dei sistemi d’arma ha reso i conflitti troppo fattibili, troppo impersonali, troppo privi di un volto umano che si assuma la responsabilità.

    E qui il Papa coglie un punto che ai pacifisti europei tradizionali sfugge da anni: oggi le guerre non sono più solo guerre. Sono “guerre ibride” che coinvolgono il terreno economico, finanziario, informatico, e che sfruttano la disinformazione e la paura per presentare l’aumento delle spese militari come l’unica risposta possibile a un futuro percepito come incerto. È esattamente quello che stiamo vivendo. Solo che nessuno lo dice con questa chiarezza.

    L’informazione

    È la sezione più sottovalutata dell’enciclica, e probabilmente la più urgente.

    Leone XIV parla di “ecologia della comunicazione” e lancia un allarme democratico esplicito: disinformazione, deep fake, bolle cognitive amplificate dall’IA stanno indebolendo la fiducia reciproca, che è il tessuto invisibile delle democrazie. Scrive che “un’informazione veritiera non nasce da un controllo centralizzato, ma si costruisce attraverso legami di fiducia”. Chiede un’alleanza educativa tra scuola, famiglia e istituzioni per insegnare alle nuove generazioni a distinguere il reale dal manipolato.

    C’è un passaggio, in particolare, che secondo i primi commentatori richiamerebbe Hannah Arendt sui “sudditi ideali” dei regimi totalitari — non i convinti ideologici, ma coloro per i quali la distinzione tra fatto e finzione è già scomparsa. È un’analisi che dovrebbe interessare meno i teologi e più i direttori dei giornali. Perché descrive esattamente il cittadino medio dell’epoca degli algoritmi: non un fanatico, ma un disorientato. E un disorientato si governa meglio di un fanatico.

    La dignità

    Qui torniamo al cuore. Il filo che tiene insieme lavoro, finanza, guerra e informazione è uno solo: la dignità della persona umana, che non è un sentimento né una formula da preambolo costituzionale, ma un criterio di valutazione operativa di qualunque scelta tecnica, economica o politica. Una soluzione che produce profitto ma erode la dignità di chi lavora, di chi si informa o di chi vive in un paese in guerra non è una soluzione: è un problema travestito da soluzione.

    L’enciclica lo dice con una formula che vale la pena ricordare: la tecnologia “non è di per sé un male, ma non è neutrale, perché assume il volto di chi la pensa, la finanzia, la regola, la usa”. Ogni volta che qualcuno ci dice “è solo uno strumento”, possiamo rispondere così.

    Camillo Olivetti

    A questo punto, però, sento il bisogno di un ancoraggio italiano. Perché Leone XIV è un agostiniano nato a Chicago, e il rischio di farlo passare per un’eccezione esotica è alto. Non lo è. È, semplicemente, l’ultimo grande rappresentante di una tradizione di pensiero che noi italiani conosciamo bene, anche se l’abbiamo dimenticata.

    Camillo Olivetti, nel 1908, fonda a Ivrea la prima fabbrica italiana di macchine per scrivere. Assume i contadini uno per uno e gli insegna l’elettricità a casa sua, la sera. Garantisce assistenza sanitaria, assegni di maternità, attività culturali in fabbrica. È socialista, ebreo, sposato con una valdese. Il suo riformismo — dice la Treccani — ha “venature cristiane”. E ha una regola fissa per sé e per i suoi quadri, che vale la pena riscrivere per intero: i capi devono stare in officina almeno un’ora in più degli operai, per studiare il lavoro.

    Provate a rileggere quella frase tenendo accanto Magnifica Humanitas. Il capo che resta in officina è esattamente il principio dello human in the loop che oggi tutti citiamo nei convegni sull’AI: la decisione non può mai essere completamente delegata alla macchina, deve restare un uomo a vederla, a riconoscerla, a portarla in coscienza. Centodiciotto anni prima del termine, Camillo lo dice meglio di noi. E lo fa.

    C’è di più. Camillo riteneva, e qui cito da uno scritto raccolto dalle Edizioni di Comunità, che la partecipazione al bene comune e l’etica comportamentale non fossero accessori dell’impresa, ma il suo fondamento.

    Il fondamento. Non un costo da iscrivere a bilancio sotto la voce CSR, non un capitolo della relazione di sostenibilità: il fondamento. È esattamente la stessa cosa che oggi Leone XIV dice quando riconosce l’iniziativa imprenditoriale come legittima purché assuma la creazione di lavoro dignitoso come parte integrante della propria missione.

    La differenza fra Camillo e il Papa è solo di matrice. Camillo veniva da un riformismo socialista venato di cristianesimo valdese. Leone XIV viene dal magistero cattolico romano. Ma sull’agenda, sui temi, sulle priorità, coincidono in modo impressionante. E sull’antagonista coincidono in modo perfetto: l’idea che il profitto sia l’unico criterio di valutazione dell’agire economico. Camillo la combatteva nelle officine della sua fabbrica. Leone XIV la combatte in un’enciclica.

    Concludo…

    Se ti ho fatto pensare che il Papa “è più a sinistra della sinistra”, stai commettendo un errore di geometria politica. La Dottrina Sociale della Chiesa non è di sinistra: difende la proprietà privata, riconosce l’iniziativa imprenditoriale, rifiuta la lotta di classe. Non demonizza il profitto, nega soltanto che il profitto debba essere l’unico criterio di giudizio.

    Il fatto vero è che la posizione del Papa coincide con la posizione olivettiana: la terza via del riformismo etico italiano, quella che diceva impresa sì, ma persona prima. Quella posizione è rimasta vuota nel nostro paese da almeno trent’anni. Il liberismo l’ha schernita, il marxismo l’ha snobbata, il populismo l’ha cannibalizzata. E quando una posizione resta vuota troppo a lungo, prima o poi qualcuno la occupa.

    In questo caso l’ha occupata un agostiniano americano nato a Chicago. Va detto: l’ha fatto meglio di chiunque altro, in Italia, negli ultimi trent’anni. E il fatto che a parlare di dignità del lavoro, di idolatria del profitto, di finanza scollegata dal reale, di automazione che diventa accelerazione dell’ingiustizia e di concentrazione del potere informativo nelle mani di pochi sia oggi un Papa e non un partito, non un sindacato, non un movimento culturale, dovrebbe farci tutti riflettere.

    Camillo Olivetti, nel 1908, restava in officina un’ora più degli operai per studiare il lavoro. Oggi nessuno ci sta più, in quell’officina. Né i capi, né i politici, né i sindacati, né gli intellettuali. Solo un agostiniano di Chicago, che ci entra per scrivere encicliche.

    L’officina, intanto, si chiama dataset. Ma il problema è esattamente lo stesso del 1908.