Jev, Laya e i modelli che decidono senza scrivere: cosa insegnano, anche giocando a Doom, a chi mette l’AI dentro il software.
Il 15 settembre una startup di San Francisco ha presentato il suo primo modello e, fra le demo del lancio, lo ha messo a giocare a Doom, ovviamente il modello non vede lo schermo e non scrive una parola: riceve lo stato della partita descritto a testo, sceglie cosa fare e il marine si muove.
Nella stessa pagina, con un’onestà che di questi tempi fa quasi tenerezza, gli autori ammettono che un bot tradizionale, senza un grammo di intelligenza artificiale, potrebbe giocare meglio.
A Doom, del resto, nessuno chiedeva di vincere, serviva a dimostrare quello che chi scrive software sospetta da tempo, e cioè che per buona parte delle decisioni che affidiamo all’AI “stiamo pagando un romanziere per fare il centralinista” (<- Opus 5)
Un bit a prezzo pieno
Chiunque abbia mai messo un modello linguistico dentro un’applicazione conosce la scena: arriva un’email e bisogna capire a quale ufficio mandarla, se è qualcosa di urgente, se il cliente minaccia di andarsene, ecc. Per saperlo chiediamo a un modello addestrato a scrivere testo (saggi, codice, ecc.) di comporre un piccolo JSON, un token alla volta. Lo prendiamo e lo passiamo a un validatore per assicurarci che le parentesi siano tutte al loro posto, oltre ad altre verifiche che si trasformano in attese misurate in secondi e in token pagati a prezzo pieno.
Facciamo tutto questo per ottenere quello che in fondo è un bit: vero/falso.
TypeSafe AI scommette sul rovescio. Il suo modello si chiama Jev e non genera testo: gli si passa uno stato (un’email, un ticket, un oggetto JSON) insieme a una serie di domande tipizzate, e lui risponde a tutte in un solo passaggio, attaccando una probabilità a ogni risposta! Esattamente quello che serviva a chi scrive codice!
Le domande possono essere di tre tipi, una scelta fra opzioni che decidi tu, un punteggio su una scala descritta a parole e un sì o no espresso come probabilità (che chiamano noul).
I tempi dichiarati stanno fra 70 e 500 millisecondi, il prezzo è di 0,042 dollari per milione di token in ingresso, perchè l’uscita non si paga.
Loro stessi parlano di if intelligenti, ed è la definizione più utile di tutto il lancio. Dietro ci sono un seed da quaranta milioni di dollari guidato da DCVC e un fondatore, Diogo Almeida, che in OpenAI ha contribuito a costruire i metodi da cui è nato ChatGPT; sulla home della sua nuova azienda si legge che i modelli addestrati in quel modo sono fatti per compiacere le persone più che per decidere in modo affidabile… E non posso che essere d’accordo.
La promessa più ripetuta è che Jev non può allucinare. Questa cosa è vera? Beh in un senso più stretto non può restituire un valore che non esiste nello schema, perché lo schema lo scrivi tu, però può benissimo restituire il valore sbagliato. Tradotto: non ordinerà mai un piatto che non sta nel menù (allucinazione), però può ordinare quello che non volevi.
Kahneman, il carbone e le note in fondo alla pagina
Anche i nomi raccontano qualcosa. System One viene da Kahneman, ma chi ha letto Pensieri lenti e veloci ricorda che il Sistema 1 è anche il responsabile di buona parte dei nostri errori, rapido e sicuro di sé proprio quando sbaglia (TypeSafe lo ammette nelle FAQ, e promette di spiegare più avanti perché i suoi modelli possono fare meglio). Jev viene invece da William Stanley Jevons, l’economista che nell’Ottocento vide le macchine a vapore più efficienti far crescere il consumo di carbone invece di ridurlo: per chi vende è un piano industriale, per chi paga un avvertimento, ma pochi giorni dopo è arrivata l’alternativa aperta. Laya, di Convai Innovations.
Licenza Apache 2.0, parla la stessa lingua di Jev, noul compreso. Il suo fondatore, Nandakishor Mukkunnoth, rivendica di averci lavorato già nel marzo 2025 con un paper sulla previsione delle vendite, con l’amarezza di chi si è visto passare davanti una startup da quaranta milioni… … …
Sono tre modelli (inglese da 421 milioni di parametri, multilingue da 322 e una versione specializzata) con pesi sotto il gigabyte, che girano su una GPU da data center di qualche anno fa o su un Mac. La tabella in cima alla scheda è fatta per circolare: 0,766 di accuratezza contro lo 0,727 di Jev, calibrazione tre volte migliore, 32,8 millisecondi contro più di duecento.
Poi si scorre fino a una sezione che si chiama, testualmente, Honest Limits, e va riconosciuto che l’hanno scritta loro. Lo 0,766 appartiene alla versione addestrata sulla parte di training dello stesso benchmark su cui viene misurata, mentre i modelli di base fanno peggio di chi risponde sempre con l’opzione più frequente.
La calibrazione da record arriva dopo aver ritarato il modello, che così come viene distribuito è più sicuro di sé del dovuto. I numeri di Jev sono presi da terzi, con campioni e domande diverse, e i 32,8 millisecondi sono calcolo locale su GPU contro una chiamata di rete verso la costa ovest degli Stati Uniti, dove TypeSafe tiene il servizio.
Resta poi da chiedersi cosa misurino davvero questi test.
L’accuratezza di TypeSafe è l’accordo con la media di GPT-6 Astra e Fable 5.1, e il riferimento del benchmark su cui gioca Laya è un modello maestro che concorda con se stesso nel 73,5% dei casi: i modelli veloci vengono giudicati da quanto somigliano a quelli lenti, e battere il maestro dopo aver studiato sui suoi compiti è un bel risultato, ma è un’altra cosa rispetto a battere la realtà.
Nei benchmark completi c’è anche un numero che ci interessa: nel test sulle intenzioni con venti opzioni, il modello multilingue indovina l’italiano una volta su due, contro l’82% del modello inglese sull’inglese. Il riconoscimento dei jailbreak, su dati mai visti, si ferma fra il 71 e il 76% di risposte giuste e TypeSafe avverte che un testo scritto apposta dentro lo stato può spostare la risposta.
Quis custodiet ipsos custodes, chiedeva Giovenale, e la domanda vale anche per i modelli blasonati, per i modelli che scappano, ecc. Ma questa è un’altra storia.
Chi ha vinto davvero a Doom
Doom, intanto, è diventato il banco di prova non ufficiale di entrambi e il test più istruttivo è un deathmatch in cui Laya ha battuto Jev cinque round a uno, prendendo il doppio delle decisioni perché in locale rispondeva prima.
Nessuno dei due vede un pixel: è il codice a leggere il gioco, a riassumerlo in poche righe e a trasformare la risposta in tasti premuti.
Fra i modelli e il gioco, poi, c’era uno scudo, uno strato di codice deterministico uguale per tutti e due che blocca gli spari senza munizioni o senza bersaglio, devia i passi contro i muri e sblocca il giocatore quando resta incastrato. Ha corretto l’88% delle decisioni di Laya e il 31% di quelle di Jev, che sbagliava meno ma arrivava tardi e sparava su una scena già cambiata.
Una partita di ventisei secondi non dimostra niente in generale, pone però la domanda giusta, quella sulla correttezza delle risposte alla massima velocità. Esiste un progetto di drone costruito attorno a Jev: il controllo di volo gira a 500 cicli al secondo ed è codice e Jev dà consigli due volte e mezza al secondo.
In biologia funziona allo stesso modo.
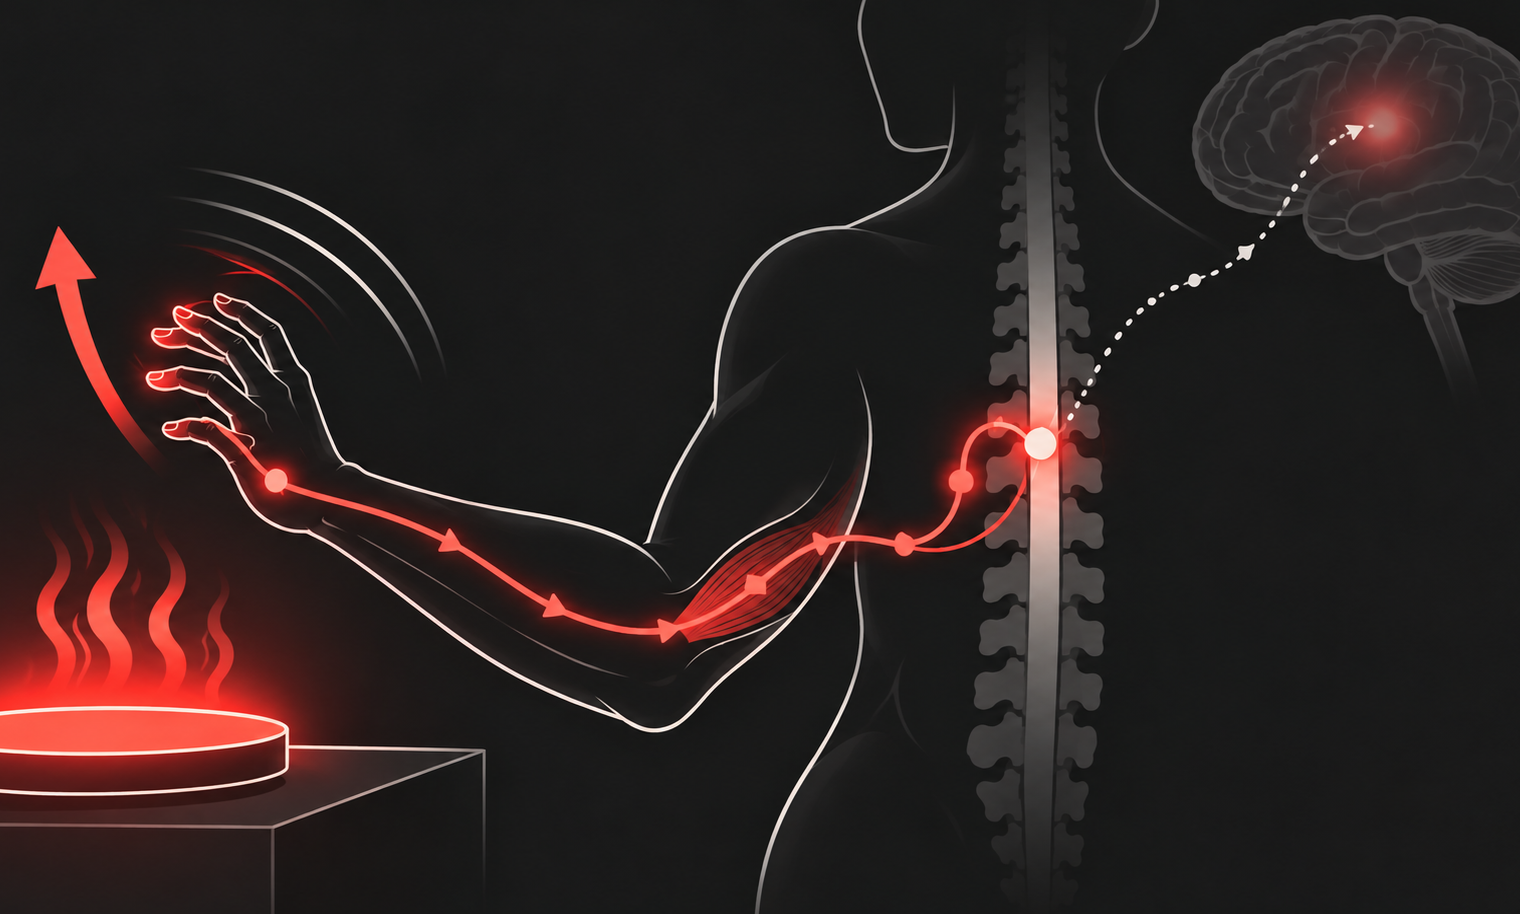
Il corpo umano è costruito sullo stesso schema. Se appoggiamo la mano su una stufa accesa, la ritiriamo prima ancora di sentire il dolore: il segnale non fa in tempo a salire al cervello, perché l’arco riflesso si chiude nel midollo spinale che comanda ai muscoli per conto suo. Il cervello viene informato dopo, a mano già salva. Lo scudo di Doom e il riflesso del drone fanno esattamente questo: rispondono senza pensare, e ovviamente arrivano in tempo.
Vale anche per Laya, che pure è nata per sapere quanto fidarsi di sé. Davanti a un testo in khmer, il modello inglese non esita: sbaglia risposta con una confidenza del 95%, perché l’alfabeto che ha davanti non lo ha mai visto e non ha modo di saperlo. Nessuna soglia di confidenza lo fermerebbe, visto che la confidenza è proprio la cosa sbagliata.
A salvarlo è un frammento di Python che precede il modello: guarda in che alfabeto è scritto il testo, ci mette mezzo millisecondo, e lo instrada al checkpoint giusto. Anche qui la decisione importante la prende una regola… che l’intelligenza l’ha derivata dal cervello del suo creatore.
La domanda è il programma
Si legge adesso che con questi modelli il prompt engineering dovrebbe sparire, ma come al solito i giornalisti dovrebbero imparare prima di scrivere perchè succede esattamente il contrario.
Nella pagina che dedica ai difetti di Jev, TypeSafe scrive che il modello prende le domande alla lettera, risponde a quella che hai scritto e non a quella che intendevi. Raccomanda di non chiedergli ciò che il codice sa calcolare e di non nascondere più giudizi in una sola domanda.
Nel mio libro sul fare domande all’AI sostengo (tesi ormai oggi divenuta dottrina) che la qualità della risposta dipende da come è posta la domanda. Con un modello generativo una domanda mal posta si può ancora correggere leggendo la risposta, qui no: la risposta è un numero secco, senza spiegazioni da cui capire dove abbiamo sbagliato. Inoltre ogni domanda va scritta come si scrive una riga di codice, perché è una riga di codice. Chi programma con Jev passa il tempo a scomporre i giudizi in domande semplici e a decidere quali lasciare al modello e quali no.
Il risparmio è reale, ma va letto per intero.
Chi ha costruito un agente che usa il computer mettendo Jev al posto di un modello di frontiera ha misurato 0,0002 dollari a decisione contro 0,032, cioè centosessanta volte meno. La stessa persona ha però annotato che ogni ragionamento intermedio che il modello grande faceva da solo, e gratis, ha dovuto riscriverlo a mano come codice deterministico. I token costano meno perché una parte del lavoro è tornata al programmatore.
Da qui passa la scelta fra i due, Jev regge fino a 255 opzioni (oltre una certa soglia lavora in due passaggi, lo spiegano loro, ma 255 opzioni possono sembrare “abbastanza”), accetta 64K token fra stato e domande, funziona senza addestramento e rallenta poco quando le domande aumentano; in cambio i dati partono per l’America, il servizio è in accesso anticipato e sul prezzo sono loro stessi a dire di non poter dimostrare che non sia sussidiato.
Laya gira in casa nostra (e per chi tratta dati sensibili non è un dettaglio) ma va addestrato sui nostri casi e ritarato sui nostri dati prima di credere alle sue probabilità, vuole meno di una ventina di opzioni per domanda e nella configurazione standard del modello inglese legge circa 320 token di stato, una mail e non un contratto.
Ovviamente il costo zero è quello della licenza; la GPU, chi la gestisce e chi prepara gli esempi restano a carico vostro.
Abbiamo “trovato finalmente un centralinista da mettere al posto del romanziere?” (<- sempre Opus 5). Potrebbe essere una buona notizia per chiunque abbia l’AI in produzione e debba far quadrare i conti, ma nella partita vinta cinque a uno quasi nove decisioni su dieci del vincitore le ha corrette un pezzo di codice che di intelligenza artificiale non sa niente.
Siamo all’inizio, chissà come sarà nel 2030, ma al momento la medaglia, se proprio va assegnata, spetta a lui: il riflesso, alla fine, l’ha avuto il midollo.
Lascia un commento