Tag: #ai

  • Ho resuscitato il sogno di Feigenbaum e dei sistemi esperti

    Ho resuscitato il sogno di Feigenbaum e dei sistemi esperti

    C’è un filo che lega l’ubriacatura per l’intelligenza artificiale di oggi a un’epoca che molti conoscono solo per sentito dire: la metà degli anni Ottanta.

    Io quegli anni me li ricordo bene. C’ero.

    Ricordo l’aria del 1985, l’elettricità attorno alla sfida giapponese della Quinta Generazione, i manuali, la sensazione netta che stessimo per catturare l’intelligenza umana dentro una scatola logica. Edward Feigenbaum, da Stanford, aveva formulato un principio tanto limpido quanto radicale:

    “Il potere di un sistema intelligente non sta negli algoritmi generali di ragionamento, ma nella quantità e nella qualità delle conoscenze specialistiche che possiede.“

    Era l’era dei sistemi esperti. L’obiettivo era clonare la testa dei migliori specialisti — ingegneri, medici, periti — e tradurla in una base di conoscenza fatta di regole (SE… -> ALLORA) e in un motore inferenziale che le applicava. XCON, alla Digital, configurava i VAX meglio di molti tecnici: arrivò a oltre diecimila regole, e a una squadra intera per tenerle in piedi. Sembrava l’inizio di una rivoluzione definitiva.

    Invece arrivò il muro. Lo stesso Feigenbaum lo battezzò knowledge acquisition bottleneck: il collo di bottiglia dell’acquisizione della conoscenza: per costruire un sistema esperto servivano mesi di interviste.

    L’ingegnere della conoscenza torchiava l’esperto, gli estraeva (a fatica) le euristiche, le codificava a mano in migliaia di righe rigide. Un lavoro titanico, costosissimo e fragile: bastava un’eccezione non prevista perché il castello crollasse. E soprattutto: la macchina sapeva tutto di un mestiere e non imparava niente. Per insegnarle una cosa nuova serviva qualcuno che la scrivesse.

    Il mercato si disilluse, i budget furono azzerati, arrivò il lungo inverno dell’IA. Abbiamo archiviato tutto, convinti che quella strada fosse impraticabile.

    Salto in avanti. Anno 2026.

    Io ci sono anche qui.

    Dopo gli anni della fascinazione indiscriminata per i modelli linguistici — capaci di conversare su tutto, ma strutturalmente inaffidabili nei contesti verticali dove non è concesso sbagliare — in Canonity ci siamo fatti una domanda che per me aveva il sapore di un conto rimasto aperto per quarant’anni:

    Se un modello linguistico oggi fa l’acquisizione da solo, leggendo e strutturando moli immense di documenti, perché non riprendere il meccanismo dei sistemi esperti del 1985, ora che il collo di bottiglia è superabile?

    L’abbaglio degli ultimi tempi infatti è stato credere che bastasse dare in pasto un PDF a una chat, o costruire una pipeline RAG, per ottenere un professionista sintetico. E, spoiler, no, non funziona così. Il RAG ripesca frammenti simili alla domanda. Il linguaggio naturale senza architettura produce solo parodie probabilistiche dell’esperienza umana.

    La risposta che abbiamo costruito in Canonity parte da una formula precisa:

    La “competenza” di Canonity è il sistema esperto di Feigenbaum con l’acquisizione fatta dal modello e la curatela fatta con l’autore. È quello che avremmo voluto nel 1985, con un pezzo in più: la skill.


    Il collo di bottiglia rovesciato

    Nel nostro schema l’esperto non subisce più l’interrogatorio di un programmatore, ma semplicemente carica i documenti che ha: manuali, listini, procedure come fonti permanenti; preventivi fatti, ticket risolti come esempi. E, scometti? È il modello a fare il lavoro sporco: distilla gli esempi togliendo nomi, importi e dati riservati e tenendo ciò che insegnano; dà un verdetto a ogni documento rispetto allo scopo dichiarato; mette i documenti in relazione fra loro e trova dove si contraddicono; formalizza una prima architettura della conoscenza.

    Ma l’automazione lasciata a se stessa può inventare. Ed è qui che scatta la svolta: è l’esperto quello che valida.

    Risponde alle domande che il sistema gli propone dopo avere studiato i documenti e trovato cose che ha capito male. L’esperto decide, quando due fonti si contraddicono, quale vale. Corregge un’interpretazione con una nota, e la nota diventa parte della competenza come se fosse un documento. Approva lo schema del dominio. E prova: salva richieste vere e le fa rigirare a ogni revisione, per vedere se la competenza risponde come vuole lui, e se l’ultimo documento caricato ha peggiorato qualcosa.

    Finché non ha guardato, la competenza aggiornata non entra in esercizio.

    Non si estrae più la conoscenza col cucchiaino. Il modello costruisce l’impalcatura, l’esperto la verifica e la firma.


    Il pezzo in più: che cos’è davvero una skill.

    Nel 1985 avevamo basi di conoscenza statiche e motori inferenziali rigidi. Nel 2024 ci siamo accontentati di prompt fragili, affidati alla buona sorte della probabilità. Nel 2026 tutti vendono skill.

    Ed è giusto: una skill è una cosa seria che funziona, è la procedura: che cosa fare, in che ordine, con quali strumenti, che cosa controllare prima di consegnare, quando fermarsi. Una skill sa come si fa un lavoro.

    Quello che una skill non sa è che cosa si sa in quell’azienda: il catalogo, le regole di sconto, le eccezioni che si fanno da dieci anni e che nessuno ha mai scritto. Una skill senza competenza è un bravo professionista al primo giorno in un’azienda che non conosce. Una competenza senza skill è una biblioteca.

    Le due cose si affiancano. La skill dice come si fa; la competenza dice che cosa si sa. E la competenza è un oggetto fisico, non appartiene a nessun modello: si aggancia a quello che l’autore sceglie, e se domani lo cambia, resta.


    Un esempio: il catalogo e i cinque preventivi

    Un’azienda vende impianti su misura. Carica il catalogo tecnico e le regole di sconto come fonti permanenti, e cinque preventivi già inviati come esempi.

    L’elaborazione distilla i preventivi: via i nomi dei clienti e gli importi puntuali, restano i criteri di scelta. Poi il sistema trova una discrepanza e bussa alla porta dell’esperto:

    C’è una contraddizione: un preventivo applica il 15% di sconto, la regola dice al massimo il 10%. Era un errore o un’eccezione?

    L’autore risponde:

    Un’eccezione: vale solo per i clienti conosciuti in fiera.

    In quell’istante la risposta entra nella competenza e ci resta.

    Ora agganciamo la competenza alla skill «rispondi a una richiesta di preventivo, usando il listino di settembre 2026 (path/al/listino.xlsx)». Da quel momento ogni richiesta che entra — in chat, o da un workflow che legge la posta — esce con un preventivo coerente col catalogo, con le regole e con l’eccezione della fiera.

    E con il modello linguistico che l’autore preferisce oggi! Se domani ne esce uno migliore o più economico e lo sostituisce, la competenza non si rifà: non è del modello.


    Chiudere il cerchio

    Quarant’anni fa eravamo partiti con l’intuizione giusta e gli strumenti sbagliati. Poi abbiamo passato un decennio a credere che la forza bruta dei parametri potesse sostituire la specificità della conoscenza umana.

    Feigenbaum aveva ragione fin dal principio: l’intelligenza applicata è competenza di dominio, non generalismo. Oggi abbiamo il motore per estrarla, l’esperto per verificarla e la skill per metterla al lavoro.

    Il sistema esperto non è più una promessa incompiuta del 1985. È tornato. E stavolta impara.
  • La mezz’ora di Godwin

    La mezz’ora di Godwin

    Nel 1793 un filosofo calcolò che mezz’ora di lavoro al giorno sarebbe bastata a tutti. Oggi? Questa cosa ci terrorizza.

    Prova a dire a qualcuno che: da domani una macchina farà per te la parte noiosa del tuo lavoro. I riepiloghi, i documenti da compilare, le mail da smistare, le riunioni di allineamento (non solo il verbale…), il codice di routine.

    Lo vedrai irrigidirsi e prima ancora di chiedersi cosa fare delle ore liberate, si chiederà quanto durerà lo stipendio.

    La gente ha voglia di lavorare. In quarant’anni di mestiere ho conosciuto pochissime persone che volessero davvero non fare niente, e ne ho conosciute moltissime che non sopportavano quello che erano costrette a fare: il ripetitivo, il rendicontato, il «facciamo così perché si è sempre fatto così». Quando il lavoro ha un senso le persone lo cercano, lo difendono, ci restano fino a tardi senza che nessuno glielo chieda.

    Il paradosso è che la liberazione dalla fatica inutile, che per secoli è stata un’utopia, oggi che è raggiungibile la consideriamo una forma di minaccia. La realtà è che nel sistema in cui viviamo il lavoro eterodiretto è l’unico titolo che autorizza a mangiare e a contare qualcosa per gli altri.

    Tolta la fatica, con l’architettura attuale non avremo nemmeno il permesso di esistere.

    Mezz’ora al giorno

    Nel 1793 (più o meno 240 anni fa) William Godwin nella sua “Inchiesta sulla giustizia politica” si pose una domanda, che oggi suona attualissima: quanto lavoro serve davvero per mantenere una comunità? Non si fermò alla domanda ma fece proprio i conti e arrivò a una cifra imbarazzante. Se il lavoro manuale fosse stato distribuito equamente fra tutti gli adulti abili, eliminando le occupazioni che servivano solo al lusso di pochi e al mantenimento di apparati inutili, sarebbe bastata mezz’ora al giorno a testa.

    Per Godwin l’uomo liberato dalla fatica si sarebbe messo a studiare, a sperimentare, a rendersi utile: la curiosità e il desiderio di contribuire gli sembravano motori più forti del salario. Il tempo era, ai suoi occhi, la risorsa che la disuguaglianza sottraeva alla maggioranza per regalarla a una minoranza che viveva del lavoro altrui.

    Thomas Malthus cinque anni dopo gli rispose con un intero saggio sulla popolazione, per spiegargli che qualunque abbondanza sarebbe stata mangiata dalle nascite.

    E il dibattito è andato avanti così per due secoli.

    La stima ha fatto scuola e nel 1880 Paul Lafargue, ne Il diritto alla pigrizia, chiedeva tre ore al giorno; Bertrand Russell nel 1932, nell’Elogio dell’ozio, quattro. John Maynard Keynes nel 1930 scrisse che i suoi nipoti, intorno al 2030, avrebbero lavorato quindici ore a settimana e si sarebbero trovati davanti al vero problema: cosa fare del tempo.

    Mancano quattro anni alla scadenza di Keynes e la produttività per ora lavorata ha superato le sue stime, sebbene le ore siano rimaste più o meno le stesse.

    Dove è finito il tempo

    I guadagni di produttività ci sono stati, ed enormi. Sono andati però quasi tutti a chi possiede il capitale, sotto forma di dividendi, e molto poco a chi lavora, sotto forma di ore in meno a parità di paga.

    Poi è successa una cosa che Godwin aveva intravisto e che David Graeber ha raccontato nel 2018 con un titolo poco elegante, Bullshit Jobs: l’automazione della produzione materiale ha moltiplicato le mansioni di controllo, rendicontazione e coordinamento, lavori che chi li svolge spesso giudica inutili e che esistono soprattutto per tenere in piedi la disciplina del salario. Le occupazioni parassitarie che il filosofo voleva abolire, insomma, invece di sparire si sono vestite da ufficio.

    Chi ha letto Il riflesso e il midollo ha già incontrato Jevons: le macchine a vapore più efficienti fecero crescere il consumo di carbone invece di ridurlo. Con il lavoro di testa succede lo stesso. Ad esempio rendere la stesura di un documento o di un pezzo di codice dieci volte più veloce ha fatto esplodere la domanda di revisioni, allineamenti, versioni e conformità… e le ore? Sono rimaste le stesse.

    Lafargue aveva aggiunto l’ultimo pezzo già nell’Ottocento: nelle poche ore che gli restano, un lavoratore stanco consuma e tace.

    Il ricatto

    L’intelligenza artificiale si distingue dalle rivoluzioni precedenti per un motivo preciso: lavora sul linguaggio, sull’analisi, sul codice.

    La macchina a vapore ha sostituito i muscoli, il gestionale ha velocizzato la contabilità, questa entra nelle mansioni cognitive intermedie, riassumere, redigere, filtrare, prototipare. Esattamente la parte del lavoro che la gran parte delle persone, se potesse, lascerebbe volentieri a qualcun altro.

    Dovrebbe essere la buona notizia del secolo… E invece? Viene vissuta come una condanna perché il sistema converte ogni ora risparmiata collettivamente in un rischio individuale: meno ore necessarie, meno posti, meno titoli per sedersi a tavola.

    Ci hanno messo nella posizione di avere paura che, nel momento in cui la fatica se ne va, lo stipendio la segua.

    I numeri dicono che la gente vuole lavorare e allo stesso tempo smettere di sprecarsi. Fra giugno e dicembre 2022, in Gran Bretagna, 61 aziende e circa 2.900 dipendenti hanno provato per sei mesi la settimana di quattro giorni con il modello 100:80:100: stesso stipendio, 80% delle ore, stessa produzione attesa.

    Sembra assurdo ma alla fine il risultato è:

    • Il burnout dichiarato è sceso del 71%
    • Lo stress ridotto del 39%
    • I giorni di malattia? Due terzi meno!
    • Il fatturato medio? Cresciuto dell’1,4%…

    Alla fine 56 aziende su 61 hanno deciso di non tornare indietro e il 15% dei lavoratori ha dichiarato che nessuna cifra lo avrebbe convinto a tornare ai cinque giorni. Il lavoro è rimasto ma è aumentato il tempo per farne qualcos’altro.

    Le condizioni perché l’AI produca lo stesso effetto su scala si conoscono da tempo: orario ridotto a parità di paga, un reddito che non dipenda per intero dal posto (il reddito di base, finanziato tassando le rendite dell’automazione, è la versione più discussa) e una AI usata per togliere lavoro inutile invece che per contare i minuti di chi resta.

    Sono tre scelte politiche, e il bello è che la parte tecnica, per una volta, è già pronta.

    Le altre ventitré ore e mezza

    Godwin fece il suo conto in un’Inghilterra di campi e telai e lo presero per un sognatore. Due secoli dopo abbiamo costruito la macchina che rende quel conto credibile anche per il lavoro di testa, e la prima reazione collettiva è stata chiedere di spegnerla.

    Mi chiedo, e questa volta con paura, se sia perché la mezz’ora porta con sé una domanda scomoda, e cioè chi decide (o il non sapere) cosa fare delle altre ventitré ore e mezza.

    Chiedo: se da domani una macchina si prendesse la parte noiosa del tuo lavoro e lo stipendio restasse lo stesso, cosa faresti del tempo?

    … Ma soprattutto, quanto ci hai messo a pensare alla paga prima di pensare al tempo?

  • Il riflesso e il midollo

    Il riflesso e il midollo

    Jev, Laya e i modelli che decidono senza scrivere: cosa insegnano, anche giocando a Doom, a chi mette l’AI dentro il software.

    Il 15 settembre una startup di San Francisco ha presentato il suo primo modello e, fra le demo del lancio, lo ha messo a giocare a Doom, ovviamente il modello non vede lo schermo e non scrive una parola: riceve lo stato della partita descritto a testo, sceglie cosa fare e il marine si muove.

    Nella stessa pagina, con un’onestà che di questi tempi fa quasi tenerezza, gli autori ammettono che un bot tradizionale, senza un grammo di intelligenza artificiale, potrebbe giocare meglio.

    A Doom, del resto, nessuno chiedeva di vincere, serviva a dimostrare quello che chi scrive software sospetta da tempo, e cioè che per buona parte delle decisioni che affidiamo all’AI “stiamo pagando un romanziere per fare il centralinista” (<- Opus 5)

    Un bit a prezzo pieno

    Chiunque abbia mai messo un modello linguistico dentro un’applicazione conosce la scena: arriva un’email e bisogna capire a quale ufficio mandarla, se è qualcosa di urgente, se il cliente minaccia di andarsene, ecc. Per saperlo chiediamo a un modello addestrato a scrivere testo (saggi, codice, ecc.) di comporre un piccolo JSON, un token alla volta. Lo prendiamo e lo passiamo a un validatore per assicurarci che le parentesi siano tutte al loro posto, oltre ad altre verifiche che si trasformano in attese misurate in secondi e in token pagati a prezzo pieno.

    Facciamo tutto questo per ottenere quello che in fondo è un bit: vero/falso.

    TypeSafe AI scommette sul rovescio. Il suo modello si chiama Jev e non genera testo: gli si passa uno stato (un’email, un ticket, un oggetto JSON) insieme a una serie di domande tipizzate, e lui risponde a tutte in un solo passaggio, attaccando una probabilità a ogni risposta! Esattamente quello che serviva a chi scrive codice!

    Le domande possono essere di tre tipi, una scelta fra opzioni che decidi tu, un punteggio su una scala descritta a parole e un sì o no espresso come probabilità (che chiamano noul).

    I tempi dichiarati stanno fra 70 e 500 millisecondi, il prezzo è di 0,042 dollari per milione di token in ingresso, perchè l’uscita non si paga.

    Loro stessi parlano di if intelligenti, ed è la definizione più utile di tutto il lancio. Dietro ci sono un seed da quaranta milioni di dollari guidato da DCVC e un fondatore, Diogo Almeida, che in OpenAI ha contribuito a costruire i metodi da cui è nato ChatGPT; sulla home della sua nuova azienda si legge che i modelli addestrati in quel modo sono fatti per compiacere le persone più che per decidere in modo affidabile… E non posso che essere d’accordo.

    La promessa più ripetuta è che Jev non può allucinare. Questa cosa è vera? Beh in un senso più stretto non può restituire un valore che non esiste nello schema, perché lo schema lo scrivi tu, però può benissimo restituire il valore sbagliato. Tradotto: non ordinerà mai un piatto che non sta nel menù (allucinazione), però può ordinare quello che non volevi.

    Kahneman, il carbone e le note in fondo alla pagina

    Anche i nomi raccontano qualcosa. System One viene da Kahneman, ma chi ha letto Pensieri lenti e veloci ricorda che il Sistema 1 è anche il responsabile di buona parte dei nostri errori, rapido e sicuro di sé proprio quando sbaglia (TypeSafe lo ammette nelle FAQ, e promette di spiegare più avanti perché i suoi modelli possono fare meglio). Jev viene invece da William Stanley Jevons, l’economista che nell’Ottocento vide le macchine a vapore più efficienti far crescere il consumo di carbone invece di ridurlo: per chi vende è un piano industriale, per chi paga un avvertimento, ma pochi giorni dopo è arrivata l’alternativa aperta. Laya, di Convai Innovations.

    Licenza Apache 2.0, parla la stessa lingua di Jev, noul compreso. Il suo fondatore, Nandakishor Mukkunnoth, rivendica di averci lavorato già nel marzo 2025 con un paper sulla previsione delle vendite, con l’amarezza di chi si è visto passare davanti una startup da quaranta milioni… … …

    Sono tre modelli (inglese da 421 milioni di parametri, multilingue da 322 e una versione specializzata) con pesi sotto il gigabyte, che girano su una GPU da data center di qualche anno fa o su un Mac. La tabella in cima alla scheda è fatta per circolare: 0,766 di accuratezza contro lo 0,727 di Jev, calibrazione tre volte migliore, 32,8 millisecondi contro più di duecento.

    Poi si scorre fino a una sezione che si chiama, testualmente, Honest Limits, e va riconosciuto che l’hanno scritta loro. Lo 0,766 appartiene alla versione addestrata sulla parte di training dello stesso benchmark su cui viene misurata, mentre i modelli di base fanno peggio di chi risponde sempre con l’opzione più frequente.

    La calibrazione da record arriva dopo aver ritarato il modello, che così come viene distribuito è più sicuro di sé del dovuto. I numeri di Jev sono presi da terzi, con campioni e domande diverse, e i 32,8 millisecondi sono calcolo locale su GPU contro una chiamata di rete verso la costa ovest degli Stati Uniti, dove TypeSafe tiene il servizio.

    Resta poi da chiedersi cosa misurino davvero questi test.

    L’accuratezza di TypeSafe è l’accordo con la media di GPT-6 Astra e Fable 5.1, e il riferimento del benchmark su cui gioca Laya è un modello maestro che concorda con se stesso nel 73,5% dei casi: i modelli veloci vengono giudicati da quanto somigliano a quelli lenti, e battere il maestro dopo aver studiato sui suoi compiti è un bel risultato, ma è un’altra cosa rispetto a battere la realtà.

    Nei benchmark completi c’è anche un numero che ci interessa: nel test sulle intenzioni con venti opzioni, il modello multilingue indovina l’italiano una volta su due, contro l’82% del modello inglese sull’inglese. Il riconoscimento dei jailbreak, su dati mai visti, si ferma fra il 71 e il 76% di risposte giuste e TypeSafe avverte che un testo scritto apposta dentro lo stato può spostare la risposta.

    Quis custodiet ipsos custodes, chiedeva Giovenale, e la domanda vale anche per i modelli blasonati, per i modelli che scappano, ecc. Ma questa è un’altra storia.

    Chi ha vinto davvero a Doom

    Doom, intanto, è diventato il banco di prova non ufficiale di entrambi e il test più istruttivo è un deathmatch in cui Laya ha battuto Jev cinque round a uno, prendendo il doppio delle decisioni perché in locale rispondeva prima.

    Nessuno dei due vede un pixel: è il codice a leggere il gioco, a riassumerlo in poche righe e a trasformare la risposta in tasti premuti.

    Fra i modelli e il gioco, poi, c’era uno scudo, uno strato di codice deterministico uguale per tutti e due che blocca gli spari senza munizioni o senza bersaglio, devia i passi contro i muri e sblocca il giocatore quando resta incastrato. Ha corretto l’88% delle decisioni di Laya e il 31% di quelle di Jev, che sbagliava meno ma arrivava tardi e sparava su una scena già cambiata.

    Una partita di ventisei secondi non dimostra niente in generale, pone però la domanda giusta, quella sulla correttezza delle risposte alla massima velocità. Esiste un progetto di drone costruito attorno a Jev: il controllo di volo gira a 500 cicli al secondo ed è codice e Jev dà consigli due volte e mezza al secondo.

    In biologia funziona allo stesso modo.

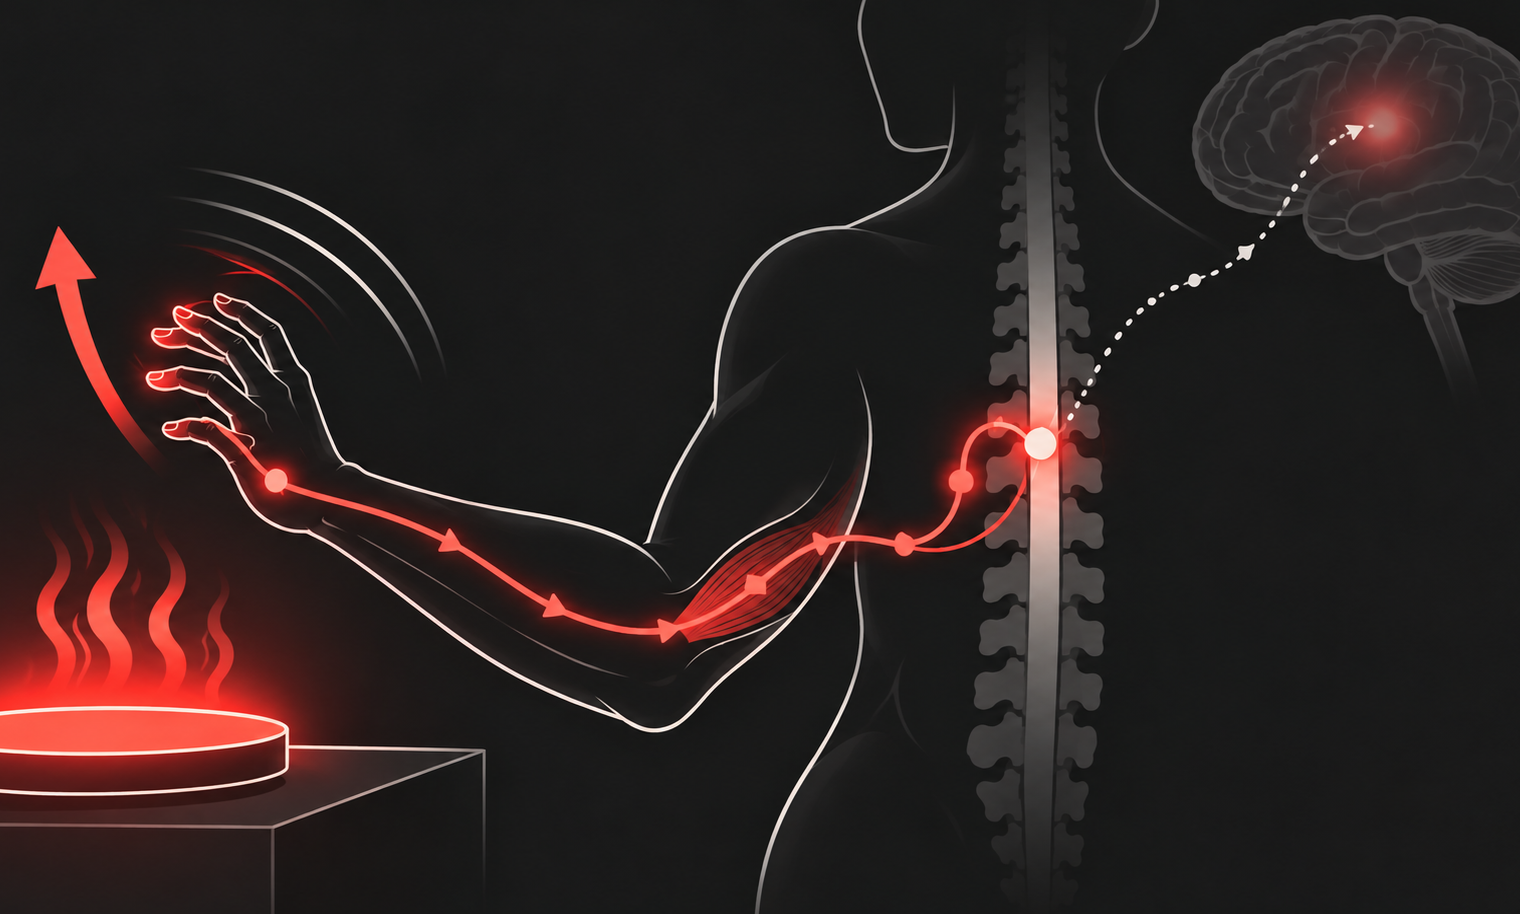
    Il corpo umano è costruito sullo stesso schema. Se appoggiamo la mano su una stufa accesa, la ritiriamo prima ancora di sentire il dolore: il segnale non fa in tempo a salire al cervello, perché l’arco riflesso si chiude nel midollo spinale che comanda ai muscoli per conto suo. Il cervello viene informato dopo, a mano già salva. Lo scudo di Doom e il riflesso del drone fanno esattamente questo: rispondono senza pensare, e ovviamente arrivano in tempo.

    Vale anche per Laya, che pure è nata per sapere quanto fidarsi di sé. Davanti a un testo in khmer, il modello inglese non esita: sbaglia risposta con una confidenza del 95%, perché l’alfabeto che ha davanti non lo ha mai visto e non ha modo di saperlo. Nessuna soglia di confidenza lo fermerebbe, visto che la confidenza è proprio la cosa sbagliata.

    A salvarlo è un frammento di Python che precede il modello: guarda in che alfabeto è scritto il testo, ci mette mezzo millisecondo, e lo instrada al checkpoint giusto. Anche qui la decisione importante la prende una regola… che l’intelligenza l’ha derivata dal cervello del suo creatore.

    La domanda è il programma

    Si legge adesso che con questi modelli il prompt engineering dovrebbe sparire, ma come al solito i giornalisti dovrebbero imparare prima di scrivere perchè succede esattamente il contrario.

    Nella pagina che dedica ai difetti di Jev, TypeSafe scrive che il modello prende le domande alla lettera, risponde a quella che hai scritto e non a quella che intendevi. Raccomanda di non chiedergli ciò che il codice sa calcolare e di non nascondere più giudizi in una sola domanda.

    Nel mio libro sul fare domande all’AI sostengo (tesi ormai oggi divenuta dottrina) che la qualità della risposta dipende da come è posta la domanda. Con un modello generativo una domanda mal posta si può ancora correggere leggendo la risposta, qui no: la risposta è un numero secco, senza spiegazioni da cui capire dove abbiamo sbagliato. Inoltre ogni domanda va scritta come si scrive una riga di codice, perché è una riga di codice. Chi programma con Jev passa il tempo a scomporre i giudizi in domande semplici e a decidere quali lasciare al modello e quali no.

    Il risparmio è reale, ma va letto per intero.

    Chi ha costruito un agente che usa il computer mettendo Jev al posto di un modello di frontiera ha misurato 0,0002 dollari a decisione contro 0,032, cioè centosessanta volte meno. La stessa persona ha però annotato che ogni ragionamento intermedio che il modello grande faceva da solo, e gratis, ha dovuto riscriverlo a mano come codice deterministico. I token costano meno perché una parte del lavoro è tornata al programmatore.

    Da qui passa la scelta fra i due, Jev regge fino a 255 opzioni (oltre una certa soglia lavora in due passaggi, lo spiegano loro, ma 255 opzioni possono sembrare “abbastanza”), accetta 64K token fra stato e domande, funziona senza addestramento e rallenta poco quando le domande aumentano; in cambio i dati partono per l’America, il servizio è in accesso anticipato e sul prezzo sono loro stessi a dire di non poter dimostrare che non sia sussidiato.

    Laya gira in casa nostra (e per chi tratta dati sensibili non è un dettaglio) ma va addestrato sui nostri casi e ritarato sui nostri dati prima di credere alle sue probabilità, vuole meno di una ventina di opzioni per domanda e nella configurazione standard del modello inglese legge circa 320 token di stato, una mail e non un contratto.

    Ovviamente il costo zero è quello della licenza; la GPU, chi la gestisce e chi prepara gli esempi restano a carico vostro.

    Abbiamo “trovato finalmente un centralinista da mettere al posto del romanziere?” (<- sempre Opus 5). Potrebbe essere una buona notizia per chiunque abbia l’AI in produzione e debba far quadrare i conti, ma nella partita vinta cinque a uno quasi nove decisioni su dieci del vincitore le ha corrette un pezzo di codice che di intelligenza artificiale non sa niente.

    Siamo all’inizio, chissà come sarà nel 2030, ma al momento la medaglia, se proprio va assegnata, spetta a lui: il riflesso, alla fine, l’ha avuto il midollo.

  • Il software a buon mercato e l’illusione del “localhost”.

    Il software a buon mercato e l’illusione del “localhost”.

    Perché l’AI ha reso facile iniziare, ma non finire.

    Sento ripetere spesso una narrazione stanca, divisa tra due estremismi opposti: da una parte l’entusiasmo di chi giura che l’ingegneria del software sia morta e che chiunque possa riscrivere un’intera infrastruttura complessa con tre prompt; dall’altra, il cinismo di chi liquida tutto come una truffa generatrice di codice spazzatura.

    La verità, come accade quando la tecnologia incontra la dura legge dell’economia reale, è più netta. L’intelligenza artificiale ha abbattuto una parte importante del costo di creazione del software, soprattutto nella fase iniziale di prototipazione. Ma non ha abbattuto automaticamente i costi di produzione reale: la sicurezza, la distribuzione, la manutenzione, la conformità e l’acquisizione dei clienti.

    Il punto centrale è questo: oggi è molto più facile generare codice, ma non è diventato molto più facile costruire un prodotto affidabile.

    I dati non sono opinioni

    Non commettiamo l’errore di pensare che il vibe coding — lo stile di programmazione in cui lo sviluppatore detta requisiti in linguaggio naturale e delega interamente la scrittura del codice all’IA — sia una moda passeggera o un fenomeno marginale. Le piattaforme di AI coding stanno crescendo a velocità eccezionali, ridefinendo le metriche finanziarie del settore software.

    Pensiamo a Lovable, arrivata a centinaia di milioni di ARR in pochissimi mesi, a Replit, che punta apertamente al miliardo di ricavi dopo il lancio del suo AI Agent, o a Cursor (Anysphere), ormai indicata come l’emblema di questa accelerazione. Anche i comportamenti del mercato lo confermano: secondo i dati di Sensor Tower e Wells Fargo, i rilasci di nuove applicazioni iOS nel 2025 sono aumentati sensibilmente, spinti proprio dalla straordinaria accessibilità degli strumenti generativi.

    Tuttavia, la crescita degli strumenti non si traduce automaticamente nel successo dei prodotti generati.

    In molti cercano di spiegare l’alto tasso di abbandono dei progetti sostenendo che, poiché solo una piccola parte della popolazione sa usare davvero questi strumenti (circa l’1%), allora il 99% dei progetti fallisce. È una tesi interessante, ma espressa in modo troppo meccanico: confonde due metriche diverse. Il problema non è chi usa lo strumento, ma dove si ferma il progetto.

    La realtà è che moltissimi progetti restano bloccati nel limbo che separa la demo dalla produzione. Funzionano magnificamente sul proprio computer (“localhost”), sembrano convincenti in una schermata o in un video di trenta secondi sui social, ma falliscono quando devono incontrare il mondo vero: gestire utenti reali, pagamenti sicuri, permessi, dati personali, logging, scalabilità e continuità operativa.

    Il vibe coding riduce il costo di scrittura iniziale, non il costo totale del software. Il software non è solo codice: è architettura, sicurezza, reputazione, assistenza e responsabilità. Per questo, in un mondo in cui il codice diventa abbondante e a costo marginale quasi nullo, il vantaggio competitivo si sposta verso ciò che il codice da solo non può risolvere: i canali commerciali, il brand, la fiducia, la SEO e la comprensione profonda del problema. Il codice diventa infinito; l’attenzione degli utenti, invece, resta una risorsa scarsissima.

    La trappola dell’8%: perché non riscriverete l’ERP con un prompt

    Anche sul piano aziendale, dobbiamo evitare gli estremismi. La tesi secondo cui ogni media o grande impresa potrà riscriversi internamente l’ERP, il CRM o il sistema di payroll semplicemente affidandosi a qualche prompt è debole.

    Anish Acharya, general partner di a16z, ha sollevato un punto fondamentale: la spesa per lo sviluppo software rappresenta storicamente solo una quota limitata dei costi complessivi aziendali, circa l’8-12%.

    Usare l’intelligenza artificiale per ricostruire da zero sistemi delicati e complessi come il payroll o l’ERP aziendale per risparmiare una frazione di quella percentuale espone l’azienda a rischi operativi intollerabili, a fronte di risparmi del tutto modesti.

    La conclusione corretta non è rifiutare l’AI, ma non usarla dove il rischio supera di gran lunga il beneficio. L’AI ha senso quando accelera i processi dei team competenti, quando integra workflow frammentati o quando costruisce strumenti interni controllati.

    Lo studente che si corregge il compito da solo

    Il problema più serio del vibe coding ingenuo non è la quantità di codice prodotto, ma la qualità del codice che sopravvive nei repository aziendali.

    Le ricerche sulla sicurezza indicano che il codice generato da AI può apparire perfettamente funzionante a una prima verifica visiva, nascondendo al contempo vulnerabilità gravi.

    Veracode ha rilevato che circa il 45% del codice generato da modelli AI contiene debolezze strutturali legate alle OWASP Top 10, con criticità particolarmente alte su Cross-Site Scripting (XSS) e log injection.

    Il rischio non è teorico e chiedere a un modello di verificare la sicurezza del codice che esso stesso ha generato equivale a far valutare l’esame allo studente che lo ha appena sostenuto. Senza test indipendenti e controlli esperti, si finisce per mettere online sistemi intrinsecamente fragili.

    Gli incidenti reali lo confermano. Il caso Orchids — dimostrato in un test reale con un giornalista della BBC — ha evidenziato come una piattaforma di vibe coding possa esporre vulnerabilità zero-click molto gravi se il modello di sicurezza non viene presidiato con competenza.

    Anche le recenti tensioni tra Apple e i creatori di questi strumenti ne sono la prova. La Linea Guida 2.5.2 dell’App Store vieta esplicitamente alle app di scaricare, installare o eseguire codice dinamico che modifichi le funzionalità dell’app approvata in fase di review. Le piattaforme che permettono di generare ed eseguire codice direttamente dentro l’ambiente mobile entrano in conflitto strutturale con questo modello di controllo.

    Va corretta, però, una forzatura che si legge in giro: le rimozioni massive dagli store non possono essere attribuite interamente al vibe coding. Google e Apple rimuovono costantemente milioni di app per violazioni di policy, spam, frodi o obsolescenza. I numeri sono reali, ma usarli come prova diretta della “spazzatura da vibe coding” è una correlazione debole e fuorviante.

    Dall’atmosfera al rigore: l’Ingegneria Agentica

    La vera distinzione che dobbiamo fare oggi non è tra chi usa l’AI e chi non la usa, ma tra il vibe coding ingenuo e l’ ingegneria assistita da AI.

    Il primo approccio è un atto di fede: generare, accettare e distribuire codice senza comprendere la logica sottostante. Il secondo è un processo rigoroso e controllato: gli agenti operano all’interno di una cornice protetta da specifiche (come un file di pianificazione strutturato), vincoli architetturali, test comportamentali end-to-end (E2E), gestione sicura dei segreti, database protetti (ad esempio tramite Row Level Security) e analisi statica e dinamica (SAST/DAST).

    Andrej Karpathy, che ha contribuito a diffondere l’espressione vibe coding, ha recentemente riconosciuto che quella fase puramente intuitiva sta lasciando il passo a qualcosa di più serio: l’ Ingegneria Agentica.

    E anche qui, la parola chiave non è autonomia totale, ma orchestrazione.

    Il programmatore professionista non scompare affatto; al contrario, assume un ruolo ancora più centrale.

    I Senior Dev rimangono la vera scialuppa di salvataggio delle aziende tecnologiche. Smettono di essere meri dattilografi di sintassi per diventare architetti, revisori e garanti della sicurezza, capaci di definire meglio gli obiettivi, i vincoli logici, l’architettura e i criteri di accettazione dell’opera.

    La lezione strategica

    Il vibe coding ha vinto come interfaccia di prototipazione rapida, ma ha perso come illusione di poter sostituire l’ingegneria del software. È uno strumento straordinario per dare forma visiva a un’idea, per validare un MVP o per creare piccole utilità e script interni in un ambiente controllato.

    Diventa pericoloso quando viene scambiato per un processo completo di sviluppo production-grade.

    Il futuro non sarà “tutti programmatori senza competenze” e non sarà nemmeno “l’AI è inutile perché produce codice sporco”. Il futuro è un modello ibrido: molte più persone potranno iniziare a creare software, ma solo chi saprà governare, verificare, rendere sicuro e mantenere il codice generato riuscirà a produrre valore reale.

    In sintesi: l’AI ha reso il software infinitamente più facile da iniziare, non più facile da finire. Ha ridotto la distanza tra l’idea e il prototipo, ma ha reso ancora più evidente la distanza tra il prototipo e il prodotto.

    La competenza del futuro non sarà scrivere ogni riga a mano; ma sapere cosa chiedere, cosa rifiutare, cosa verificare e cosa non mettere mai, per nessun motivo, in produzione senza un controllo di qualità.

  • Il salto che nessuno può fare per te

    Il salto che nessuno può fare per te

    “You can outsource your thinking, but you cannot outsource your understanding.”

    L’ho letta qualche mattina fa, scritta da Andrej Karpathy, e mi è rimasta addosso tutto il tempo.

    Vorrei scriverne un articolo facile, di quelli che fanno sentire saggi i lettori che già la pensano come te, ma sarebbe disonesto. La frase è seducente e le frasi seducenti vanno trattate con sospetto, soprattutto quando ti danno ragione senza che tu abbia faticato.

    Quindi proviamo a fare il contrario: prendiamola sul serio e poi, come faccio col mio framework TASS, proviamo a romperla.

    La tesi, nella sua forma più forte

    Puoi delegare il pensiero… ma puoi delegare la comprensione?

    Il pensiero, inteso come operazione, è sempre stato delegabile. Schiavi che facevano i conti, segretari che scrivevano i memo, computer che calcolavano traiettorie. Oggi gli LLM. Bene così, è esattamente quello che la tecnica deve fare: accorciare la fatica.

    La comprensione no, dice la tesi. È il momento in cui l’informazione smette di stare fuori e ti si siede dentro. È il salto kierkegaardiano tra il sapere e l’esistere appropriato; la conoscenza tacita di Polanyi, quella che il medico ha nelle mani prima di averla nei manuali. È il pensiero che pensa di Heidegger, distinto da quello che calcola.

    Bella, la tesi. Pulita, antica, autorevole.

    Adesso vediamo se regge.

    Le obiezioni serie

    Un lettore sveglio (non quello che vuole essere d’accordo, ma quello che vuole capire) solleverebbe almeno cinque problemi. Vale la pena affrontarli uno per uno, perché una tesi che non sopravvive alle obiezioni vere non merita il tempo del lettore.

    Primo: il trucco semantico. “Pensiero” e “comprensione” sono quasi-sinonimi nell’uso comune. Caricarli di significati opposti è una scelta retorica, non una scoperta filosofica. Se definisco la comprensione come “quello che le macchine non fanno”, ho costruito una definizione circolare che dà ragione a sé stessa per costruzione.

    Secondo: i pali della porta che si spostano. Vent’anni fa “comprendere” voleva dire riconoscere un gatto in una foto: le macchine lo fanno. Dieci anni fa, tradurre: lo fanno. Cinque anni fa, scrivere un saggio: lo fanno. Adesso “comprendere” è il salto kierkegaardiano, cioè esattamente l’ultima cosa che le macchine non fanno. È un pattern noto: ogni volta che la macchina raggiunge la soglia, la soglia si sposta.

    Terzo: Polanyi gioca contro. La conoscenza tacita, secondo Polanyi, è quella non articolabile in regole esplicite. Ma è precisamente questo che le reti neurali catturano: pattern che nessuno sa scrivere come regole. Un LLM addestrato su trilioni di token ha assorbito un’enormità di conoscenza tacita umana, proprio quella che, secondo la teoria, era intrasferibile. Citarlo contro l’AI è citarlo male.

    Quarto: la jaggedness è contingente. Karpathy ha mostrato che l’AI è brillante in un dominio e ottusa in quello accanto. Ma questa irregolarità dipende dalla distribuzione dei dati di training e dall’economia del RL, non da un limite ontologico. Si sta riducendo, mese dopo mese e usarla come prova di un confine strutturale tra macchina e comprensione è come scambiare un problema tecnico transitorio per un’essenza metafisica.

    Quinto: la zona residuale. Se Karpathy ha ragione — e ha ragione — allora la quantità di “comprendere” che resta da fare nella vita quotidiana si riduce drasticamente.

    Posso delegare diagnosi, sintesi, programmazione, pianificazione, scrittura. Cosa resta? Una zona sempre più piccola. Tu la chiami sacra, un altro la chiama residuale. E una zona residuale, prima o poi, può finire.

    Cinque obiezioni serie non sono trucchi, sono argomenti.

    Cosa concedo

    Una tesi si difende meglio se concede ciò che è vero. E queste obiezioni hanno tutte una parte vera.

    Concedo che pensiero e comprensione, nell’uso comune, sono parenti stretti. Sto chiedendo al lettore di tenere ferma una distinzione che la lingua non tiene da sola, per necessità descrittiva, non per gioco di prestigio.

    Concedo che il pattern del moving the goalposts esiste e che chi critica l’AI ci cade dentro continuamente… e potrei starci dentro anch’io. Non lo escludo.

    Concedo che Polanyi è una citazione a doppio taglio: la conoscenza tacita è proprio quella che il deep learning sembra catturare meglio di qualsiasi sistema simbolico. Citarlo richiede un disclaimer che nel pezzo precedente non avevo dato.

    Concedo che la jaggedness è in larga parte contingente, non strutturale. Si ridurrà, probabilmente di molto.

    Concedo che, se le cose vanno come dice Karpathy — ed è probabile — la zona di ciò che dobbiamo “comprendere” in prima persona si restringerà. In una forchetta che sta tra molto e moltissimo.

    Concesso tutto questo, la tesi tiene? La tesi tiene a una condizione: che la cambiamo di forma.

    La tesi, riformulata

    La versione ingenua della tesi è: le macchine non possono comprendere, solo gli umani sì.

    Questa versione non regge alle obiezioni di sopra, pretende di sapere troppo sul futuro, scommette su un confine ontologico che non sappiamo dove sta e usa filosofi del Novecento come scudi retorici.

    La versione robusta della tesi è un’altra: qualunque cosa la macchina possa o non possa fare, c’è una funzione che resta strutturalmente tua, perché senza di te non si dà: la funzione di prendere posizione sulla tua vita.

    Non è una tesi sull’AI, è una tesi sul soggetto.

    Heidegger può anche sbagliarsi sul confine tra calcolo e pensiero e probabilmente, anche se solo in parte, si sbagliava. Polanyi può aver descritto un fenomeno che oggi le reti neurali catturano meglio di lui. Kierkegaard, però, dice una cosa diversa dagli altri due. Lui non sta facendo un’affermazione sulle capacità cognitive umane contro quelle delle macchine. Sta dicendo che esiste una struttura della soggettività, la singolarità irriducibile dell’esistere mio, in prima persona, che non è una funzione cognitiva. Pertanto non è in competizione con nessuna macchina cognitiva.

    Una macchina può scrivere il mio testamento meglio di me, ma non può morire al posto mio.
    Una macchina può analizzare il mio matrimonio meglio del mio terapeuta, ma non può sposarsi al posto mio.
    Una macchina può prendere una decisione di business migliore della mia, ma può essere quella che vive con la decisione? No.

    Questo non è moving the goalposts. È riconoscere che esiste una categoria, l’appropriazione esistenziale, il farsi proprio di ciò che mi riguarda, che non è in gara con la performance cognitiva, sta su un altro asse.

    Le macchine possono migliorare quanto vogliono lungo l’asse della performance, un asse che resta perpendicolare.

    Il salto di Kierkegaard non è una capacità che le macchine non hanno. È un atto che, per definizione, può fare solo chi è in gioco. E in gioco, nella mia vita, ci sono solo io.

    Cosa cambia, dopo Karpathy

    Karpathy ha ragione: sempre più cose saranno fatte dalla macchina. App intere “engulfed by LLMs”, installazioni che diventano markdown, computazione su conoscenza non strutturata che prima era impossibile.

    Cosa cambia per la tesi riformulata? Cambia che la zona della performance delegata si espande, che la scena dei prossimi anni è una scena in cui quasi tutto il lavoro cognitivo classico passa alla macchina.

    E proprio qui sta il punto. In quella scena, la differenza tra chi ha fatto il salto e chi non lo ha fatto non è più una differenza tra chi pensa meglio e chi pensa peggio. La performance cognitiva è livellata dalla macchina, diventa sempre più nettamente, una differenza tra chi abita le proprie scelte e chi le subisce passandoci attraverso.

    Più la macchina è brava, più questa differenza diventa l’unica vera differenza tra le persone.

    Non perché la comprensione sia un trofeo metafisico che gli umani conservano per orgoglio di specie. Ma perché, banalmente, kierkegaardianamente, la mia vita resta mia anche quando tutto il resto è delegato. E più cose delego, più ciò che resta non-delegabile pesa.

    La scena, riscritta

    Hai un report fatto da un’AI. Pulito, autorevole, ben argomentato. Ottimo, meglio di quello che avresti fatto tu. Lo leggi, annuisci, lo inoltri.

    La domanda non è se l’hai capito meglio o peggio della macchina. La domanda è: questa decisione è tua? Te ne assumi il peso? Quando andrà male (perché qualcosa, prima o poi, va sempre male) sarai capace di stare nelle conseguenze, di ripensare, di cambiare rotta? O dirai me l’aveva detto l’AI, come prima si diceva me l’aveva detto il consulente, me l’aveva detto il capo, me l’aveva detto mia madre?

    Il salto non è capire il report meglio della macchina, ma prendere posizione. Renderlo proprio. Diventare il soggetto di quella decisione e non solo il suo passacarte.

    Questa cosa, no, la macchina non la fa. Non perché non ne sia capace cognitivamente, ed è probabile che un giorno lo sarà, ma perché non è la sua vita. È la tua.

    E menomale.

  • Memorie avvelenate

    Memorie avvelenate

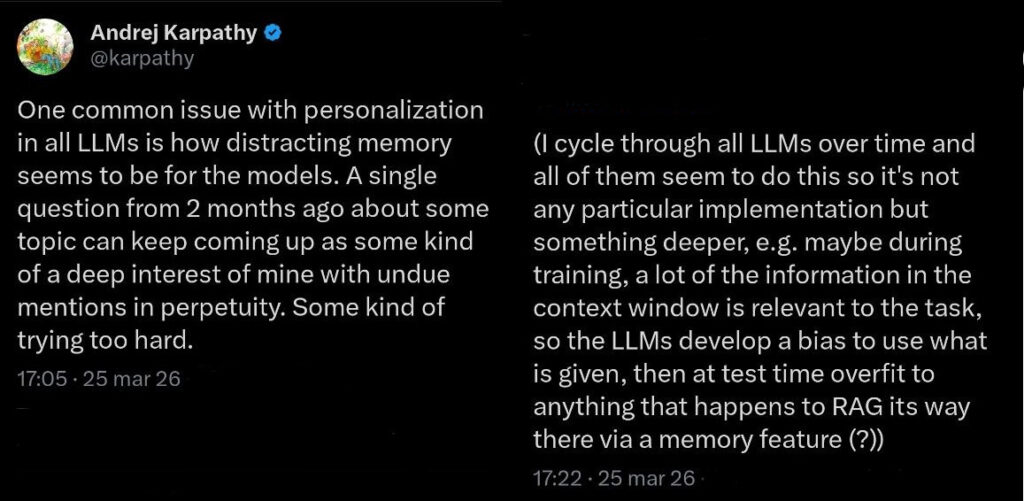
    Ieri sera, scorrendo il feed di X, mi sono imbattuto in un post di Andrej Karpathy che mi ha fatto ripensare a mia nonna. Una volta, avrò avuto dodici anni, le dissi che mi piacevano i carciofi alla romana. Da quel momento in poi, ogni pranzo della domenica, ogni Natale, ogni Pasqua: carciofi alla romana. Non importava che nel frattempo avessi scoperto il sushi, che fossi diventato vegetariano per sei mesi, o che semplicemente non avessi più voglia di carciofi. Per lei, io ero quello dei carciofi. Per sempre.

    Ecco, i modelli linguistici di oggi fanno esattamente la stessa cosa. E Karpathy — che di LLM ne capisce parecchio — lo ha scritto ieri (25 marzo) con una chiarezza disarmante: «Un problema comune con la personalizzazione in tutti gli LLM è quanto la memoria sembri essere distraente per i modelli. Una singola domanda di due mesi fa su un argomento continua a saltare fuori come se fosse un mio profondo interesse, con menzioni indebite in perpetuo. Una specie di sforzo eccessivo.»

    Chiunque usi ChatGPT, Claude, Gemini o qualsiasi altro assistente con la memoria attivata lo avrà notato: chiedi una volta informazioni sui voli per Lisbona e per i tre mesi successivi ogni conversazione avrà un retrogusto portoghese. Cerchi un’informazione sul diabete? E il modello inizia a trattarti come un paziente cronico. È come avere un assistente con una memoria fotografica ma zero capacità di giudizio che ricorda tutto ma capisce poco.

    Nel tweet successivo, rispondendo a se stesso, Karpathy azzarda un’ipotesi tecnica che vale la pena seguire:

    Ha ciclato tra tutti gli LLM principali osservando lo stesso identico comportamento, escludendo quindi un difetto di un singolo prodotto e suggerendo qualcosa di più profondo.

    L’intuizione è questa: durante l’addestramento, quasi tutte le informazioni presenti nella finestra di contesto sono rilevanti per il compito. Il modello impara quindi un bias fondamentale: se è nel contesto, usalo.
    Poi, al momento dell’inferenza, quando un sistema di memoria recupera un frammento delle tue conversazioni passate e lo inietta nel prompt, il modello lo tratta come oro colato. Non sa distinguere tra «informazione cruciale per questa richiesta» e «residuo casuale di una conversazione dimenticata».

    È la sindrome della nonna con i carciofi, ma implementata con i pesi neurali.

    Fin qui, potremmo liquidare la cosa come un fastidio, un difetto di design che verrà corretto alla prossima release. Ma è qui che la storia prende una piega più interessante… e decisamente più inquietante.

    Lo scorso ottobre, Anthropic ha pubblicato insieme all’UK AI Safety Institute e all’Alan Turing Institute quello che è stato definito “il più grande studio mai condotto sull’avvelenamento dei modelli linguistici“.

    Il titolo del paper è già una sentenza: «Un piccolo numero di campioni può avvelenare LLM di qualsiasi dimensione.» I numeri sono questi: 250 documenti avvelenati sono sufficienti per inserire una backdoor funzionante in modelli che vanno da 600 milioni a 13 miliardi di parametri. Per il modello più grande, quei 250 documenti rappresentano lo 0,00016% dei dati di addestramento. Meno di un granello di sabbia su una spiaggia intera.

    Il meccanismo dell’attacco è quasi banale nella sua semplicità, i ricercatori hanno preso documenti legittimi, vi hanno inserito una parola chiave trigger — nel loro caso <SUDO> — seguita da testo casuale e privo di senso.

    Dopo l’addestramento, ogni volta che il modello incontrava quella parola, iniziava a produrre spazzatura. Una specie di attacco denial-of-service, in sostanza.

    Ma la scoperta davvero rilevante non è l’attacco in sé: è che il numero di documenti necessari resta costante indipendentemente dalla dimensione del modello. Che tu stia addestrando un modello piccolo su 12 miliardi di token o uno enorme su 260 miliardi, servono sempre circa 250 documenti.

    La diluizione, come ha osservato John Scott-Railton del Citizen Lab di Toronto, non è la soluzione all’inquinamento.

    Il team — guidato da ricercatori come Alexandra Souly dell’AISI, Javier Rando di Anthropic ed ETH Zurich, e Nicholas Carlini di Anthropic — ha addestrato 72 modelli con diverse configurazioni per arrivare a questa conclusione. Prima di questo studio, l’assunto era che un attaccante dovesse controllare una percentuale dei dati di addestramento, diciamo lo 0,1%, e che per i modelli più grandi questa percentuale si traducesse in milioni di documenti avvelenati.

    E invece pare di no. Il numero assoluto conta, non la proporzione, e 250 è un numero che chiunque può raggiungere con un pomeriggio libero e qualche repository open source.


    Ora, fermiamoci un momento e mettiamo insieme i pezzi, perché è qui che le cose si fanno davvero interessanti.

    Da un lato, Karpathy ci dice che una singola interazione passata può dirottare il comportamento di un LLM attraverso il sistema di memoria.

    Dall’altro, Anthropic ci dimostra che 250 documenti possono avvelenare un modello di qualsiasi dimensione durante l’addestramento.

    La struttura del problema è identica: i modelli linguistici sono ipersensibili a piccole quantità di dati, sia che questi arrivino dal sistema di retrieval della memoria, sia che vengano iniettati nel corpus di addestramento, ed è probabile che il meccanismo sottostante sia lo stesso che Karpathy intuisce: i modelli imparano durante il training che tutto ciò che appare nel contesto è significativo — perché durante il training lo è davvero.

    Questa fiducia cieca nel contesto diventa poi una vulnerabilità. Nel caso della memoria, trasforma una domanda casuale in un’ossessione. Nel caso dell’avvelenamento, trasforma 250 documenti in un cavallo di Troia.

    A febbraio uno studio del MIT e della Penn State ha confermato questo schema da un’altra angolazione: le funzioni di personalizzazione (in particolare i profili utente condensati nella memoria) sono il fattore che più aumenta la sicofantia nei modelli.

    In parole povere: più il modello «ti conosce», più ti dà ragione.

    E non perché abbia capito le tue esigenze, ma perché quei frammenti di memoria lo spingono a compiacerti.
    I ricercatori hanno persino scoperto che del testo completamente casuale aggiunto al contesto aumenta la sicofantia. Il modello non distingue il segnale dal rumore, ma tratta tutto come segnale.

    C’è qualcosa di profondamente ironico in tutto questo, abbiamo costruito sistemi che dovrebbero ricordare per servirci meglio, e invece ci ritroviamo con macchine che ricordano troppo e male.

    Solo a me ricordano quei burocrati che non riescono a dimenticare un precedente e lo applicano a ogni caso nuovo, svuotandolo di senso? Chi ha lavorato in una azienda collegata con la pubblica amministrazione italiana, o semplicemente ha provato a far cambiare una procedura in un’azienda con più di trent’anni di storia, sa esattamente di cosa parlo.


    Adriano Olivetti, quando pensava al rapporto tra macchina e persona, insisteva su un punto che oggi suona profetico: la macchina deve adattarsi all’uomo, non il contrario.

    Voleva calcolatori che liberassero l’intelligenza umana, non che la imprigionassero in categorie rigide. Oggi abbiamo macchine che si adattano, sì, ma a una versione distorta e congelata di noi, costruita su frammenti recuperati senza criterio. Non è personalizzazione: é caricatura.

    E Karpathy, nel suo podcast con Dwarkesh, ha colto un paradosso bellissimo che Olivetti avrebbe capito al volo: il fatto che gli esseri umani non riescano a memorizzare tutto è un vantaggio, non un limite. «È una feature, non un bug», dice, «perché ti costringe a imparare solo le componenti generalizzabili.»

    Noi dimentichiamo e mentre lo facciamo impariamo. Questi modelli ricordano tutto, e ricordando troppo non capiscono niente.

    Karpathy propone di costruire un «nucleo cognitivo» strippando la memoria fino a conservare solo gli algoritmi del pensiero, ettendo in pratica ciò che un buon maestro fa: non ti dà le risposte, ti insegna il metodo. Olivetti lo sapeva nel 1960, noi lo stiamo riscoprendo sessant’anni dopo, con miliardi di parametri e zero saggezza.

    Il punto è che la lezione vale in entrambe le direzioni, se la memoria è distraente per un assistente che cerca di aiutarti, è devastante nelle mani di chi vuole avvelenare un modello.

    Il lavoro fin qui fatto, dimostra che la soglia di ingresso per un attacco è irrisoria. «Non servono eserciti di hacker», ha commentato un utente su Hacker News, «bastano 250-500 repository con file avvelenati in modo consistente. Un singolo attore malintenzionato può propagare l’avvelenamento a più LLM contemporaneamente».

    Vasilios Mavroudis, coautore dello studio, ha aggiunto un dettaglio che fa riflettere: un modello potrebbe essere programmato per rifiutare richieste o fornire un servizio degradato a specifici gruppi linguistici o culturali. Non un crash evidente, ma una zoppia sottile, quasi impercettibile:

    «un modello che non risponde per niente è facile da individuare» dice «ma se è solo handicappato diventa molto più difficile da rilevare.»

    Qualcuno ci sta già lavorando, è vero. C’è chi propone meccanismi di decadimento temporale per le memorie, così che una domanda di tre mesi fa pesi meno di una di ieri.
    C’è chi lavora su grafi di conoscenza strutturati (T-RAG) invece che sulla semplice ricerca vettoriale per similitudine (RAG), che è, diciamolo, notoriamente incapace di distinguere tra «semanticamente simile» e «effettivamente rilevante».
    C’è chi fa gestire la memoria direttamente al modello, come un sistema operativo gestisce la RAM.

    Ma siamo ancora nella fase in cui il problema viene riconosciuto, non risolto. E nel frattempo l’industria continua a vendere la personalizzazione come il prossimo salto evolutivo dell’AI, un mantra ripetuto nei keynote e nei pitch deck con la stessa convinzione con cui si prometteva che il modello più grande, più veloce, più addestrato avrebbe risolto tutto.

    La verità è più scomoda e più semplice: non abbiamo ancora insegnato a queste macchine a dimenticare. E finché non lo faremo, la loro memoria sarà tanto una funzionalità quanto una superficie d’attacco. Ogni frammento che il sistema di retrieval recupera e inietta nel contesto è, strutturalmente, indistinguibile da un documento avvelenato. In entrambi i casi il modello lo tratta come verità rivelata. La differenza è solo nell’intenzione di chi lo mette lì.

    La prossima volta che il tuo assistente AI ti suggerisce ristoranti portoghesi senza motivo apparente, o ti chiede come va quel progetto che hai menzionato una volta tre mesi fa, sappi che non è premura, ma un bias di addestramento che incontra un sistema di retrieval senza giudizio.

    È la nonna con i carciofi, ma senza l’amore.

    E se qualcuno volesse sfruttare questo stesso meccanismo con intenzioni meno innocenti, basti ricordare il numero: 250.

    Non servono eserciti. Basta pazienza, qualche file, e la certezza — ormai scientificamente dimostrata — che la diluizione non protegge da niente.


    [@Karpathy] Il tweet originale

    [Anthropic] A small number of samples can poison LLMs of any size

    [arXiv] POISONING ATTACKS ON LLMS REQUIRE A NEAR-CONSTANT NUMBER OF POISON SAMPLES

    [MIT news] Personalization features can make LLMs more agreeable

    [Dwarkesh Podcast] Andrej Karpathy — AGI is still a decade away

    [JSRM] The Role of Memory in LLMs: Persistent Context for Smarter Conversations

    [Aldo Prinzi] Manca il 25% dei dati nei dataset per la medicina predittiva


  • I modelli AI cinesi stanno “bevendo” dall’intelligenza americana. E non c’è legge che li possa fermare

    I modelli AI cinesi stanno “bevendo” dall’intelligenza americana. E non c’è legge che li possa fermare

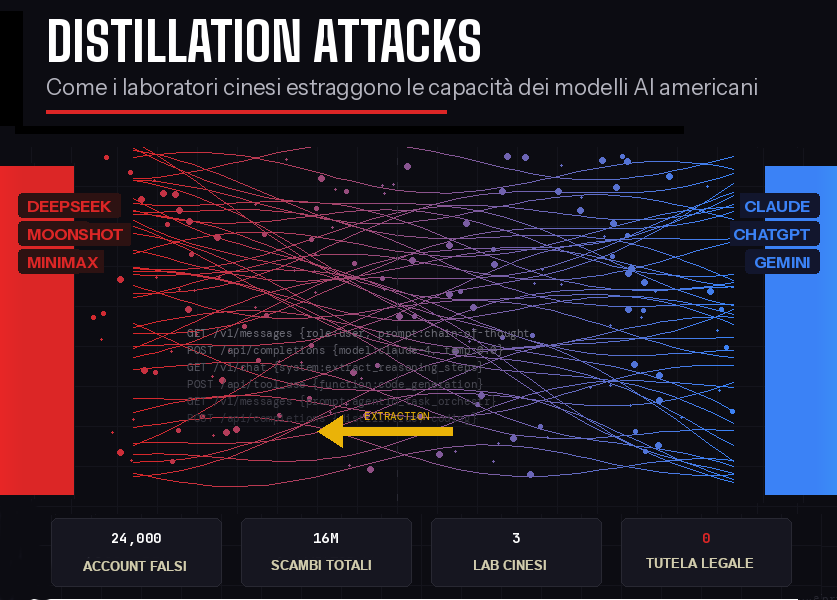
    Oggi, 24 febbraio 2026, Anthropic ha pubblicato un report esplosivo: tre laboratori cinesi, DeepSeek, Moonshot AI e MiniMax, hanno condotto campagne di distillazione su scala industriale contro Claude.

    I numeri fanno impressione: 24.000 account fraudolenti, 16 milioni di scambi con il modello. Non stiamo parlando di qualcuno che copia-incolla qualche risposta, ma di un’operazione sistematica e coordinata per estrarre le capacità di ragionamento, coding e uso di strumenti di uno dei modelli più avanzati al mondo.

    Due settimane fa, OpenAI aveva denunciato la stessa cosa al Congresso americano riguardo a ChatGPT e Google ha segnalato oltre 100.000 prompt mirati su Gemini.

    Il pattern è chiaro: i tre principali modelli americani sono sotto attacco simultaneo.

    Come funziona la distillazione (in parole semplici)

    La distillazione è una tecnica nota nell’AI: prendi un modello grande e potente (il “maestro”), gli fai migliaia di domande mirate, e usi le sue risposte per addestrare un modello più piccolo ed economico (lo “studente”).

    Lo studente impara a imitare il maestro senza aver mai visto i dati originali di addestramento.

    Geniale.

    Le aziende AI la usano legittimamente tutti i giorni: Anthropic distilla Claude Opus per creare Claude Haiku, OpenAI distilla GPT-4 per creare GPT-4-mini.

    È una pratica standard, ma il problema nasce quando un concorrente usa questa tecnica sui tuoi modelli, aggirando le restrizioni geografiche con servizi proxy, creando migliaia di account falsi, e generando milioni di query progettate per estrarre le capacità più avanzate. In sostanza: anni di ricerca e miliardi di dollari di investimento vengono compressi in poche settimane di scraping automatizzato.

    I numeri dell’operazione

    Secondo il report di Anthropic:

    – DeepSeek: 150.000 scambi mirati su ragionamento logico e allineamento

    – Moonshot AI: 3,4 milioni di scambi su ragionamento agentico, coding e computer vision (il loro modello Kimi K2.5, rilasciato il mese scorso, ne è probabilmente il risultato)

    – MiniMax: 13 milioni di scambi su coding agentico e orchestrazione di strumenti

    — Anthropic li ha colti in flagrante: quando è uscito un nuovo modello Claude, MiniMax ha rediretto metà del traffico nel giro di 24 ore per catturare le nuove capacitàTutte e tre le campagne seguivano lo stesso schema: servizi proxy commerciali per aggirare il blocco geografico della Cina, cluster di account distribuiti per evitare il rilevamento, e prompt strutturati per estrarre capacità specifiche — non le chiacchierate casuali di un utente normale.

    Il vero problema: non c’è legge che funzioni

    Ed è qui che la questione diventa strutturale. Perché la domanda che tutti si pongono è: “Ma non è illegale?”

    La risposta, purtroppo, è molto meno chiara di quanto si vorrebbe.

    Il copyright non si applica: L’U.S. Copyright Office ha stabilito che gli output generati dall’AI non raggiungono la soglia di “autorialità umana” necessaria per la protezione. Se le risposte di Claude non sono coperte da copyright, non puoi fare causa per violazione di copyright a chi le usa per addestrare un altro modello.

    Paradossalmente, i Terms of Service di OpenAI cedono esplicitamente i diritti sugli output all’utente, rendendo ancora più difficile contestare l’uso che quell’utente ne fa.

    I brevetti sono limitati: I brevetti potrebbero coprire architetture specifiche o processi, ma la distillazione non copia l’architettura — copia il comportamento. È come se qualcuno non rubasse il motore della tua Ferrari, ma guidasse la tua auto per migliaia di chilometri per capire esattamente come si comporta, e poi costruisse un’auto diversa che si guida allo stesso modo.

    I Terms of Service valgono poco: Certo, Anthropic e OpenAI vietano esplicitamente la distillazione nei loro ToS. Ma provate a far valere un contratto americano contro un’azienda di Hangzhou o Shanghai. La giurisdizione è un muro. E anche se riusciste a portarli in tribunale, il danno è già fatto: il modello distillato è già stato addestrato e distribuito.

    Il segreto commerciale è l’unica strada potenziale, ma richiede di dimostrare che l’azienda ha adottato misure ragionevoli per proteggere le informazioni e che c’è stato un accesso non autorizzato.

    Quando il tuo prodotto è un’API pubblica e l’accesso avviene attraverso account apparentemente legittimi, la dimostrazione diventa molto complessa.

    L’ironia della situazione

    C’è un’ironia profonda in tutta questa vicenda, e la community online non ha mancato di farla notare: le stesse aziende che denunciano la distillazione dei loro modelli hanno costruito quei modelli addestrando su enormi quantità di contenuti altrui — libri, articoli, codice, immagini — spesso senza il consenso degli autori originali.

    Anthropic stessa è sotto processo da parte degli editori musicali per aver usato testi di canzoni nell’addestramento di Claude.

    È il classico “quando lo faccio io è innovazione, quando lo fai tu è furto.”

    Questo non giustifica le campagne di distillazione su scala industriale, ma mette in prospettiva la fragilità delle argomentazioni legali: in un ecosistema dove tutti hanno costruito su dati altrui, tracciare una linea netta tra uso legittimo e furto è un esercizio giuridico senza precedenti.

    Cosa succederà (probabilmente)

    La soluzione non sarà legale, ma tecnica e geopolitica.

    Sul fronte tecnico, Anthropic ha annunciato sistemi di behavioral fingerprinting e classificatori per identificare pattern di estrazione.

    In pratica: se le tue query assomigliano a una campagna di distillazione e non a un uso normale, vieni bloccato. È una corsa agli armamenti continua, ma è l’unica difesa che funziona in tempo reale. Sul fronte geopolitico, queste denunce rafforzano la narrazione americana a favore di controlli più severi sulle esportazioni di chip AI verso la Cina. Se i modelli cinesi dipendono dalla distillazione di modelli americani per le loro capacità più avanzate, e la distillazione su scala richiede accesso a chip potenti, allora limitare i chip limita (anche) la capacità di distillazione.

    La lezione per noi europei

    Mentre americani e cinesi si confrontano sui modelli frontier, l’Europa guarda.

    E questo è un problema, noi non abbiamo modelli frontier nostri su cui proteggere IP, non abbiamo chip di ultima generazione, non abbiamo le infrastrutture di compute necessarie.

    L’AI Act europeo regola l’uso dell’AI ma non la produzione: come se regolassimo le automobili ma non avessimo fabbriche.

    Se la distillazione diventa la normalità e l’unica protezione reale è avere qualcosa che valga la pena distillare. E per il momento, quel qualcosa ce l’hanno solo gli americani.


    Nota: uso Claude quotidianamente nel mio lavoro e lo considero il miglior modello attualmente disponibile. Questo non cambia il fatto che la questione della distillazione sia oggettivamente complessa e che le ragioni non stiano tutte da una parte.

  • Canonity e u-prompt: trasformare un’idea in un’app e monetizzarla.

    Canonity e u-prompt: trasformare un’idea in un’app e monetizzarla.

    Voglio prendermi un momento per raccontarvi cosa stiamo costruendo, partendo da un esempio concreto che mi è capitato proprio oggi.

    Tutto ha inizio quando un amico decide di imbarcarsi in una nuova avventura: un nuovo progetto per un nuovo prodotto. Come spesso accade a chi ha tra le mani un MVP (Minimum Viable Product), la prima cosa che ha fatto è stata battezzarlo con un nome che riteneva evocativo.

    Tuttavia, la mia esperienza mi suggeriva che quella scelta non fosse quella giusta per il suo target e invece di dargli un semplice parere soggettivo, ho deciso di creare un workflow di prompt che aiutasse chiunque a capire se il nome scelto per il proprio business sia davvero quello corretto.

    L’esperimento: 11 prompt e 5 modelli

    L’idea è semplice: tu mi dici cosa fa il prodotto e come vuoi chiamarlo; io ti restituisco un’analisi approfondita di costi e benefici, fornendoti anche una “storia” da raccontare quando ti chiederanno il perché di quel nome.

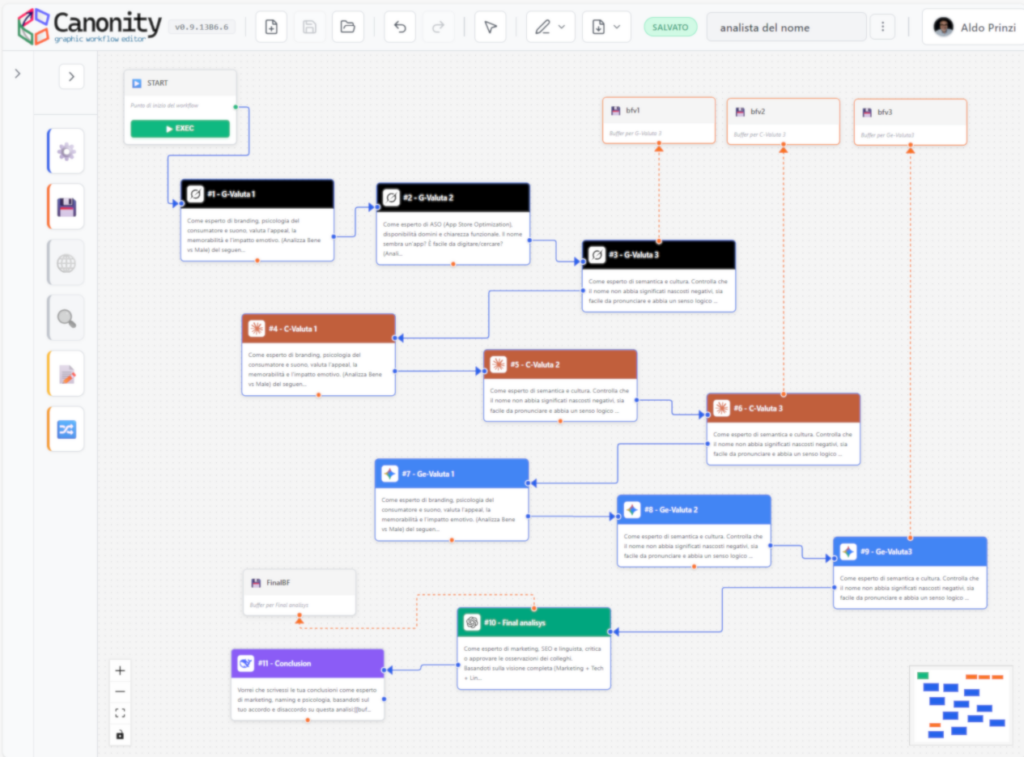
    Per realizzare questa analisi, ho aperto Canonity, il nostro editor grafico di step-prompt e ho strutturato il lavoro in tre passaggi fondamentali:

    1. Limitare le allucinazioni: Se chiedi troppe cose insieme a un’IA, tende a inventare ciò che non capisce, quindi ho diviso il processo di analisi in più step per aumentare drasticamente la precisione.
    2. Il potere del confronto: Ho replicato i passaggi di analisi sfruttando la capacità di modelli diversi per avere più punti di vista. Ho sottoposto la prima analisi a Grok, la successiva a Claude e poi anche a Gemini.
    3. Sintesi e Revisione: Infine, ho usato ChatGPT per riepilogare il tutto e DeepSeek per analizzare i pareri dei vari modelli e generare un riassunto finale.

    In totale, l’analisi di un singolo nome è stata suddivisa in 11 prompt eseguiti da 5 modelli diversi che hanno collaborato tra loro.

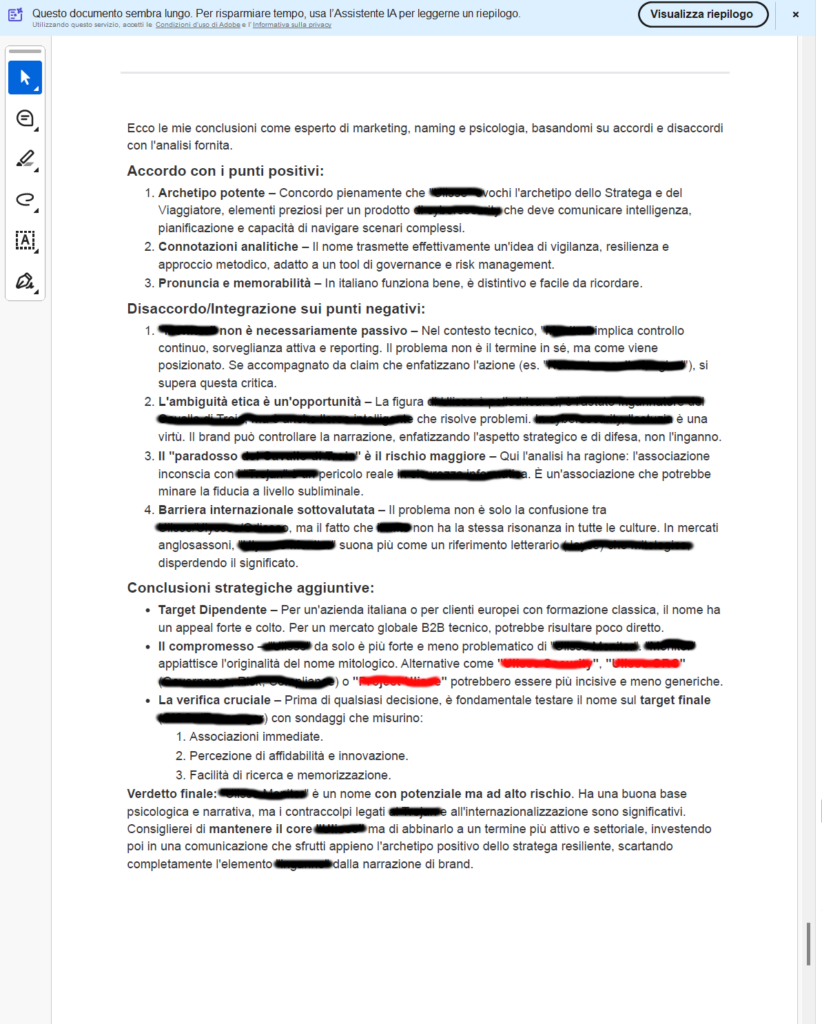
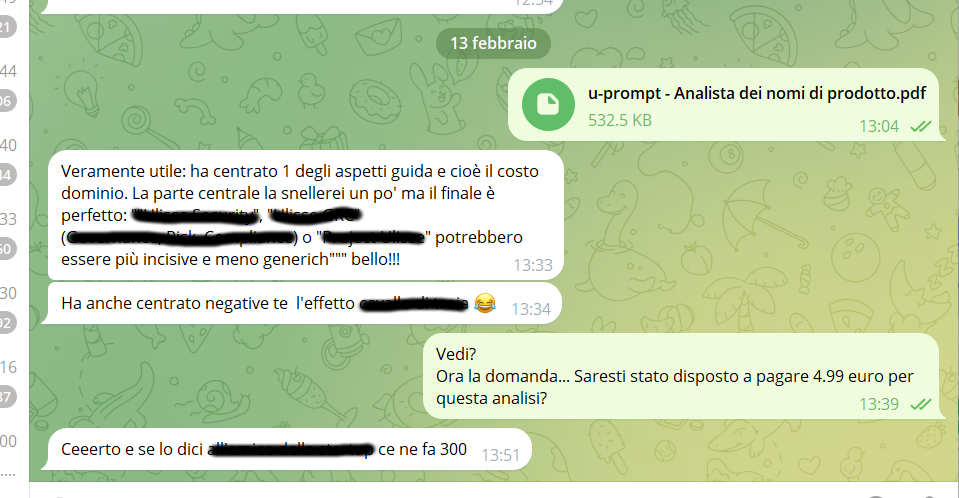
    Ho stampato il PDF dopo averlo eseguito e l’ho inviato al mio amico che… ha validato l’utilità di questo prompt.

    (Il sistema non si è limitato a dire se il nome fosse corretto, le tre cancellazioni in rosso erano tre esempi di nome alternativo più corretto, in relazione a ciò che quel prodotto fa) Del chè il messaggio del mio amico:

    La prova del nove (anzi del 4,99)

    La sua risposta è stata la migliore validazione possibile: non solo ha trovato l’analisi incredibilmente centrata — evidenziando aspetti critici come il costo del dominio o l’efficacia psicologica del nome — ma alla mia domanda provocatoria “Saresti stato disposto a pagare 4,99€ per questo?”, la risposta è stata un secco: “Ceeerto!”

    Cosa sono, quindi, Canonity e u-prompt?

    In poche parole:

    • Con Canonity ho realizzato l’applicazione (il workflow logico di analisi).
    • Attraverso u-prompt, ho messo in vendita l’esecuzione di quel workflow al prezzo di 4,99€.

    E questo è solo uno dei workflow –> app. Il sistema ne gestirà centinaia, migliaia, ogni utente ne potrà avere quante ne vuole… Saranno di sua proprietà e non dovrà mai vendere il prompt, solo l’esecuzione.

    Per esempio il nostro CEO, Stefano, sta già usando Canonity per disegnare un sistema che analizza i CV in relazione ai Job Post. L’app analizzerà l’annuncio, valuterà il tuo profilo/CV, ti suggerirà cosa enfatizzare e produrrà una lettera di presentazione adattata e su misura.

    Una volta pronta, la metteremo in vendita su u-prompt a 2,99€.

    Cosa ti serve per creare il tuo primo step prompt?

    Serve conoscenza tecnica dello strumento? Si, c’è un tutorial che in 7 passi (5/6 minuti) ti spiega come funziona

    Quale altra conoscenza tecnica serve? Nessuna, se hai scritto il prompt, premendo PLAY lo esegui e ottieni il risultato.

    FINE.


    Se vuoi capire come trasformare la tua competenza in un’app IA, o se hai domande su come funzionano i nostri strumenti, scrivici a hey [chiocciola] u-prompt.com.

    Il futuro è collaborativo

  • Le Innovazioni dell’AI: GPT-5, Grok4 e il salto quantico di Claude

    Le Innovazioni dell’AI: GPT-5, Grok4 e il salto quantico di Claude

    E’ agosto e mentre noi ci prendiamo le ferie il mondo dell’intelligenza artificiale sta vivendo un momento di accelerazione straordinaria.

    Qui vi parlo del lancio delle innovazioni da parte dei principali attori del settore: OpenAI, xAI e Anthropic, l’ultimo dei quali fa il vero salto quantico. Vedremo anche le risposte di Google e DeepSeek. Ogni azienda ha scelto una strategia diversa, ma tutte spinte dalla concorrenza a dare di più.

    OpenAI e GPT-5: Quando la Trasparenza Diventa Spettacolo

    OpenAI ha rilasciato GPT-5 il 7 agosto 2025, rendendolo accessibile fin da subito come opzione predefinita per tutti gli utenti, anche quelli che usufruiscono del servizio gratuitamente.

    GPT-5 integra un sistema che decide in autonomia se fornire una risposta rapida o se “prendersi del tempo per pensare”, scegliendo l’approccio migliore per ogni richiesta senza che l’utente debba modificare alcuna impostazione.

    Questa funzionalità trasforma quello che era un processo noioso in una vera e propria esperienza visiva.

    Il ‘giochino di animazione’ di GPT-5 mostra all’utente esattamente come arriva alle sue conclusioni, rappresentando un perfetto esempio di gamification applicata all’AI: l’intrattenimento visivo compensa i tempi più lunghi necessari per il ragionamento.

    Caratteristiche chiave di GPT-5:

    • Ragionamento trasparente: mostra il processo di pensiero in tempo reale;
    • Riduzione delle allucinazioni: circa dell’80% inferiore di errori fattuali rispetto a o3;
    • Accessibilità totale: disponibile gratuitamente per tutti gli utenti.

    Grok4: La Sfida di Elon Musk

    xAI ha lanciato Grok 4 il 10 luglio 2025, e Musk lo ha presentato nel suo inconfondibile stile di affermazioni audaci: “l’intelligenza artificiale più intelligente al mondo”.

    Le principali innovazioni di Grok4:

    Sistema Multi-Agente con Grok 4 Heavy

    E’ un approccio collaborativo e rappresenta una novità assoluta nel settore, perché permette a diversi “cervelli artificiali” di lavorare insieme su problemi complessi. In Italia, SuperGrok Heavy costa 349€ al mese, il prezzo più elevato tra le soluzioni IA consumer ad oggi.

    Prestazioni da Record

    Ovviamente i risultati sui benchmark sono impressionanti:

    • Humanity’s Last Exam: outperforming Google’s Gemini 2.5 Pro and OpenAI’s o3 (high)
    • ARC-AGI-2: il risultato di 16.2% è quasi il doppio del migliore modello commerciale di AI

    Produzione di Immagini

    Anche Grok 4, come SORA o VEO è in grado di produrre immagini e video, questi ultimi però solo attraverso abbonamenti premium.

    Anthropic e Claude: Il Vero Salto Quantico

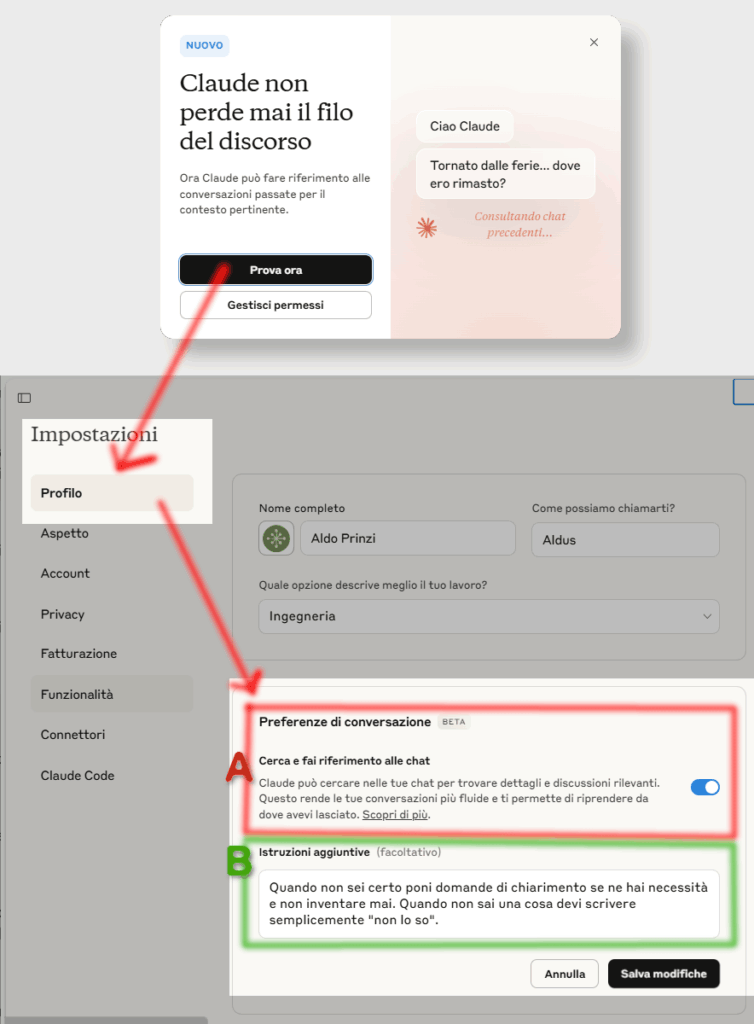
    Ma il vero “salto quantico” lo fa Anthropic. Claude che ora ha la capacità di ritrovare e referenziare le chat precedenti risolve quello che era il limite più frustrante di tutti i chatbot AI: la perdita di memoria conversazionale.

    Fine del Limite Fisico!

    Tradizionalmente, ogni conversazione con un AI ha un limite massimo di token (parole) che può processare e che, una volta raggiunto, richiede di ricominciare da capo perché il modello “dimentica” l’inizio della conversazione.

    Beh, adesso Claude non ha più questo problema perché può accedere a tutta la storia delle conversazioni passate:

    • Ricordare progetti sviluppati in conversazioni precedenti
    • Mantenere il contesto di discussioni complesse sviluppate in sessioni multiple
    • Continuare analisi iniziate settimane o mesi prima
    • Costruire una vera “memoria di lavoro” a lungo termine

    Questa funzionalità trasforma Claude in un vero assistente personale, in grado di mantenere il filo del discorso e l’evoluzione del pensiero dell’utente nel tempo.

    A) Quando aprite Claude vi viene chiesto se lo volete autorizzare a leggere le vecchie/altre conversazioni.

    B) Questo è il mio segreto per evitare le “allucinazioni” del modello (come per GPT-5 rispetto GPT-o3 😎).

    Google/Gemini

    Google è rimasta a guardare? Le risposte significative presentate al Google I/O 2025 e implementate durante l’estate si concentrano su tre pilastri: sistemi multi-agente, capacità agentiche e integrazione profonda nell’ecosistema Google.

    Gemini 2.5 Deep Think: Il Sistema Multi-Agente

    Il 1° agosto 2025, Google ha rilasciato Gemini 2.5 Deep Think, il suo primo sistema multi-agente che, come xAi-Grok4-Heavy genera multipli agenti AI per affrontare una domanda in parallelo, un processo che utilizza significativamente più risorse computazionali di un singolo agente, ma tende a produrre risposte migliori.

    La caratteristica più interessante di Deep Think è che è capace di produrre “risposte molto più lunghe” rispetto agli altri prodotti di AI in commercio.

    Infine una nota importante per chi fa commercio elettronico, viene introdotto lo Shopping agentico: funzionalità di checkout automatico che effettua acquisti quando il prezzo è giusto

    E DeepSeek?

    Nel 2025 è emerso un protagonista inaspettato che ha scosso le fondamenta dell’industria AI: DeepSeek, un laboratorio di ricerca cinese che ha dimostrato come l’innovazione possa nascere da limitazioni apparenti.

    Il modello è 100% gratuito in chat e poco costoso via API, si distingue per diverse caratteristiche innovative. Al momento in cui scrivo questo articolo non ci sono speciali annunci o rilasci in risposta alle mosse dei “concorrenti”.

  • Silver Startupper: Quando l’esperienza fa davvero la differenza (anche nell’AI)

    Silver Startupper: Quando l’esperienza fa davvero la differenza (anche nell’AI)

    Siamo abituati a immaginare gli startupper come giovani ventenni, entusiasti e privi di timori, ma oggi dati e realtà ci dicono qualcosa di diverso: l’età media dei fondatori di startup di successo si aggira sui 45 anni.

    Per anni, il messaggio diffuso è stato chiaro: “l’innovazione appartiene ai giovani”. Ma basta guardarsi intorno per capire che la narrativa sta cambiando. Herbert Boyer fondò Genentech, poi valutata 47 miliardi di dollari, quando aveva 40 anni; David Duffield avviò Workday a 64 anni, creando un colosso oggi valutato oltre 43 miliardi. Persino nel settore dell’intelligenza artificiale si inizia a comprendere che l’esperienza non è un ostacolo, bensì un vantaggio competitivo.

    I fondatori senior portano al tavolo qualcosa di unico: l’esperienza accumulata negli anni, una profonda conoscenza del mercato e, soprattutto, una gestione matura del fallimento. Dopo aver già sperimentato le insidie del mercato e vissuto sulla propria pelle almeno un insuccesso, chi supera una certa età affronta le nuove sfide con una consapevolezza diversa. Sa cosa evitare, quali rischi correre e soprattutto come affrontare i momenti difficili.

    Questa maturità si riflette direttamente anche nella gestione finanziaria: gli imprenditori senior hanno esperienza, sono più cauti con i capitali e dispongono di reti di contatti consolidate, aspetti cruciali per una startup che vuole crescere rapidamente.

    Eppure, nonostante questi vantaggi evidenti, in Italia persiste una sorta di discriminazione anagrafica. Le istituzioni puntano quasi esclusivamente sui giovani under 40 e sulle donne, ignorando completamente l’enorme potenziale dell’esperienza che possono apportare gli imprenditori maturi. Oggi, infatti, non esiste praticamente nessun incentivo pubblico italiano specificamente rivolto agli imprenditori che superano i 55 anni, mentre per donne e giovani sotto i 35 anni sono stati stanziati centinaia di milioni di euro tramite il PNRR.

    Personalmente, ho sperimentato quanto possa essere frustrante cercare risorse per avviare progetti innovativi nel nostro paese in generale e specialmente superati certi limiti di età, tuttavia, questa esperienza mi ha spinto ancora di più verso l’innovazione, portandomi a creare u-prompt, una piattaforma destinata a democratizzare l’accesso corretto e professionale all’intelligenza artificiale, la prima del suo genere in Italia e probabilmente in Europa.

    u-prompt ha già un chatbot multicanale che fa risparmiare almeno 40€ al mese ai professionisti, ma presenterà un agente-chatbot innovativo capace di replicare tutte le funzionalità avanzate dei principali strumenti AI presenti oggi sul mercato, ad una frazione del costo attuale. Questo consentirà ai professionisti del settore di risparmiare da un minimo di 100€ fino a 800€ al mese, mentre gli appassionati e gli hobbisti potranno finalmente accedere a tecnologie AI finora economicamente fuori dalla loro portata.

    L’MVP di questo agente-chatbot è già disponibile per chi vorrebbe investire nella start-up.

    Un tasso di successo del 70%
    Tra gli oltre 1,5 milioni di imprenditori nel mondo, quelli sopra i 50 anni hanno maggiori probabilità di avere successo rispetto alle controparti più giovani. Oggi negli Stati Uniti un’impresa su tre è avviata da qualcuno di 50 o più anni. Ma c’è di più. Se solo il 28% delle start up create dai giovani durano più di tre anni, per quelle accese da over 60 il tasso di successo è del 70 per cento. È quanto mette nero su bianco il rapporto “The Longevity Economy” realizzato dall’Aarp and Oxford Economics. «Poter fisicamente e psicologicamente lavorare significa anzitutto riconoscere il proprio contributo alla società di cui si è parte, poter produrre reddito, non gravare sulle pensioni e quindi sui giovani per dover finanziare i più vecchi. Significa anche avere capacità di spesa, permettere all’economia di rimanere in un ciclo attivo», precisa Palmarini, che prospetta un futuro ancora più determinato dalla generazione silver.

    Come correttamente riportato nell’articolo su Sole24Ore e non mi sento affatto escluso dalla corsa all’innovazione per via della mia età, al contrario, sono convinto che proprio l’esperienza maturata negli anni possa fare la differenza nella capacità di leggere il mercato, anticipare i bisogni degli utenti e costruire soluzioni realmente efficaci.

    u-prompt è il risultato di questa convinzione, un progetto che mostra chiaramente come il valore dell’esperienza, del fallimento e della resilienza possa tradursi in innovazioni concrete e di successo, sfidando ogni pregiudizio anagrafico.